Detección anormal en video de Big Data con un codificador automático mejorado
Jul 12, 2023
1. Introducción
Como tarea de visión por computadora de alto nivel, la detección de anomalías de video se refiere a la detección automática de eventos anormales en una secuencia de video determinada, que puede distinguir de manera efectiva actividades anormales y normales y categorías anormales en el video. En los últimos años, los investigadores han llevado a cabo muchas investigaciones relacionadas con la detección de anomalías [1–9]. En comparación con los eventos normales, los eventos que rara vez ocurren o tienen una baja probabilidad de ocurrencia generalmente se consideran anormales. Sin embargo, en la práctica, es difícil establecer un modelo efectivo de detección de anomalías debido a tipos de eventos desconocidos y definiciones poco claras de anomalías. La mayoría de los métodos de detección de anomalías existentes están diseñados en base a la suposición de que cualquier patrón diferente del patrón normal aprendido se considera anomalía. Con base en tales supuestos, la misma actividad en diferentes escenarios puede representarse como eventos normales o anormales. Por ejemplo, una escena de pelea en la que dos personas pelean en la calle puede considerarse anormal, mientras que las dos personas son normales cuando están boxeando. Además, hay una gran cantidad de información visual redundante en los datos de video de alta dimensión, lo que aumenta la dificultad de la representación de eventos en la secuencia de video.

Cistanche de hierbas chinas
Según trabajos anteriores, los métodos de detección de anomalías se pueden dividir generalmente en dos tipos. Algunos métodos de detección de anomalías están diseñados a través de errores de reconstrucción, que se enfocan en modelar patrones normales en secuencias de video [3–5, 7, 8, 10, 11]. (Estos métodos aprenden el modelo de representación de características del patrón normal en la fase de entrenamiento y usan las diferencias entre las muestras normales y anormales para determinar la puntuación anormal final de los datos de prueba durante la fase de prueba, como errores de reconstrucción o umbrales específicos [7 –14]. Aunque los métodos de detección de anomalías basados en la reconstrucción son buenos para reconstruir patrones normales en secuencias de video, el problema clave con estos métodos es que dependen en gran medida de los datos de entrenamiento. Otro tipo de método considera la detección de anomalías como un problema de clasificación [ 15, 16]. Para estos métodos, la puntuación de anomalía de una secuencia de video se predice mediante el uso de un clasificador entrenado para extraer características como un histograma de tipo óptico (HOF) o textura dinámica (DT). (El rendimiento de estos métodos es altamente dependiente de las muestras de entrenamiento Para obtener un rendimiento satisfactorio, la extracción de características efectivas y discriminativas es esencial para tales métodos de detección de anomalías [17-20]. Sin embargo, los dos tipos de métodos suelen modelar las relaciones entre eventos de una manera relativamente simple [7, 10, 21–23]. Por ejemplo, solo se considera la relación lineal, que no es suficiente para relaciones complejas altamente no lineales en muchos casos del mundo real.
Cistanche viva del desierto
En los últimos años, los métodos basados en el aprendizaje profundo se aplicaron al campo de la videodetección y lograron grandes avances [24–26]. Por ejemplo, los autocodificadores (AE) utilizan errores de reconstrucción para detectar anomalías, y sobre esta base se han mejorado una serie de métodos. Además, también se han aplicado redes generativas antagónicas (GAN) y memoria a corto plazo (LSTM) para resolver el problema de detección de anomalías. Sin embargo, el AE puede tener una fuerte capacidad de generalización, lo que resulta en la capacidad de reconstruir eventos anormales. En [14], los investigadores señalaron que debido a que no hay muestras de entrenamiento anómalas, la reconstrucción de las muestras anómalas debería ser impredecible, lo que puede dar lugar a errores de reconstrucción mayores para las muestras anómalas. Si algunas anomalías comparten un patrón de composición común con datos de entrenamiento normales o el decodificador es "demasiado fuerte" y no puede decodificar bien algunos códigos de anomalía, entonces el AE puede reconstruir bien la anomalía. Para superar las deficiencias de la AE, este documento utiliza un módulo de memoria para mejorar la AE profunda y desarrolla un método de AE con memoria aumentada (Memory AE). Cuando se ingresa una nueva muestra de prueba, Memory AE no la codificará ni la ingresará directamente en el decodificador, sino que la usará como una consulta para recuperar el contenido relevante en el módulo de memoria. (es decir, el contenido se agrega y se pasa al decodificador. (Este proceso se realiza mediante el direccionamiento de la atención. Además, este documento utiliza operadores de reducción diferenciables para inducir la escasez de pesos de direccionamiento de memoria, lo que puede alentar el contenido de la memoria para abordar consultas en la característica espacio.Durante la fase de entrenamiento, el codificador y el decodificador actualizan el módulo de memoria al mismo tiempo para obtener un error de reconstrucción promedio más bajo.En la fase de prueba, el contenido de la memoria aprendida es fijo y se utilizará una pequeña cantidad de elementos de memoria normales para la reconstrucción. Si estos se seleccionan como el vecindario del código de entrada, el error de reconstrucción será muy obvio. Los experimentos en varios conjuntos de datos de referencia públicos muestran que el rendimiento de detección de Memory AE ha alcanzado el estado del arte.

Principales componentes químicos de Cistanche deserticola
2. Principio del Algoritmo
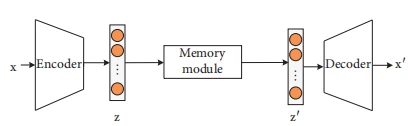
La Figura 1 muestra la estructura general de la red de Memory AE, que se divide en tres subestructuras: codificador (usado para codificar entradas y generar consultas), decodificador (usado para reconstrucción) y módulo de memoria (con memoria y operaciones de direccionamiento relacionadas). Como se muestra en la Figura 1, dado el evento a probar, el codificador primero obtiene su valor codificado. Al usar el valor codificado como una consulta, el módulo de memoria recupera el contenido más relevante en el módulo de memoria a través de un operador de direccionamiento basado en la atención y luego lo pasa al decodificador para su reconstrucción. Durante el entrenamiento, el codificador y el decodificador optimizan los parámetros para minimizar el error de reconstrucción y, al mismo tiempo, actualizan el módulo de memoria para registrar los elementos prototipo de los datos normales codificados. Dada una muestra de prueba, el modelo usa solo los patrones normales limitados registrados en el módulo de memoria para realizar la reconstrucción. De esta forma, la reconstrucción tiende a acercarse a la muestra normal. Por lo tanto, el error de reconstrucción de la muestra normal es pequeño y el error anormal es grande.
Figura 1: (e diagrama de flujo de la memoria propuesta AE.
2.1. Codificadores y Decodificadores. (El codificador y el decodificador son dos partes del AE. (El primero asigna los datos de entrada al espacio de características para obtener su valor codificado, y el segundo reconstruye el valor codificado en los datos de entrada. (El AE se compone de un codificador fw1 (·) y un decodificador gw2 (·), que se puede expresar como
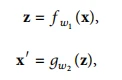
donde x y x′ son la entrada del AE y la entrada reconstruida, respectivamente, z son los resultados de codificación de x, y W1 y W2 indican los parámetros del codificador y el decodificador, que se pueden obtener minimizando el error de reconstrucción entre x y x′:
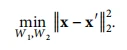
Al reconstruir el error de la muestra normal [19, 20] para determinar si es anormal, el AE se ha utilizado con éxito para resolver la tarea de detección anormal. Sin embargo, la reconstrucción de muestras anómalas debe ser impredecible, lo que puede dar lugar a errores de reconstrucción mayores para las muestras anómalas. Para resolver este problema, en la Sección 2.2 se presenta un módulo de memoria para el AE y se propone un AE de memoria.
2.2. Módulo de memoria. (El método propuesto incluye un módulo de memoria para registrar el modo de codificación del prototipo y una operación de direccionamiento para acceder al módulo de memoria.
2.2.1. Representación basada en la atención. (El módulo de atención está diseñado como una matriz M ∈ RN×C que contiene N vectores en tiempo real. Para simplificar, suponga que C es la dimensión de z; luego, sea Ζ � RC. Dado un vector fila mi, ∀i ∈ [ N], donde [N] es un número entero de 1 a N. Cada uno representa mi un elemento de memoria, dado un conjunto de consultas z ∈ RC, la red de memoria obtiene?z y responde con un vector de dirección flexible w ∈ R1×N como sigue:
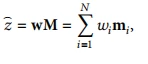
donde w es un vector fila y la suma de todos los elementos es 1, lo que representa wi, el elemento w de i. (El vector de peso se puede obtener mediante el cálculo de z. Como se muestra en la ecuación (4), el peso de la dirección debe estar cerca del módulo de memoria. (El parámetro mixto se define como N, la capacidad máxima del módulo de memoria. Aunque es N, no es fácil encontrar el mejor para diferentes conjuntos de datos, afortunadamente, Memory AE no es sensible a la configuración de N. Suficientemente, N grande se puede aplicar bien a cada conjunto de datos.
2.2.2. Atención para el direccionamiento de memoria. En Memory AE, el módulo de memoria está diseñado para registrar en detalle el modo normal original M de la fase de entrenamiento. (El módulo de memoria se define como memoria direccionable de contenido, z⌢, y su esquema de direccionamiento calcula w, el peso de atención, en función de la similitud entre la consulta y el elemento de memoria. Como se muestra en la Figura 1, cada peso se puede calcular a través de la operación softmax wi:
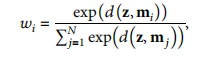
donde d(·, ·) representa la medida de similitud. (El papel lo define como una similitud de coseno:
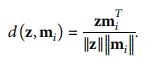
Al igual que las ecuaciones (4)–(6), el módulo de memoria recupera el elemento de memoria más similar para obtener una representación de z. Debido a la limitación del tamaño de la memoria y la escasa tecnología de direccionamiento, solo se puede direccionar una pequeña cantidad de elementos de la memoria interna a la vez. (Por lo tanto, el comportamiento efectivo del módulo de memoria se puede explicar de la siguiente manera. En la fase de entrenamiento, el decodificador en Memory AE se limita a usar muy pocos elementos de memoria direccionables para la reconstrucción, lo que requiere un uso efectivo de los elementos de memoria. (Por lo tanto, , durante la reconstrucción, el módulo de memoria debe ser forzado a registrar el modo prototipo más representativo en el modo normal de entrada. En la fase de prueba, dada la memoria entrenada, solo se puede recuperar el modo normal en la memoria para la reconstrucción. (por lo tanto , las muestras normales se pueden reconstruir mejor. Por el contrario, el valor codificado de la entrada anormal se puede reemplazar por el patrón normal recuperado, lo que da como resultado un gran error de reconstrucción en la muestra anormal.
2.3. Capacitación. Dado un conjunto de datos que contiene muestras xi? ?TI�1, sea xi′ las muestras de reconstrucción de xi en las muestras de entrenamiento; la refactorización mínima se realiza de la siguiente manera:
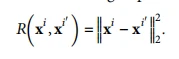
(La norma l2 se usa para medir el error de reconstrucción; wi′ representa el peso de direccionamiento de memoria de cada muestra xi. Para promover aún más la dispersión de w′, la regularización dispersa se minimiza durante el entrenamiento. Considerando que todos los w′ son no negativos y ‖w′‖1 � 1, se forma un problema de optimización de la siguiente manera:
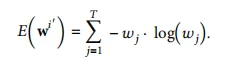
Al combinar la función de pérdida de la ecuación (7) y la ecuación (8), la función objetivo de la Memoria AE es la siguiente:
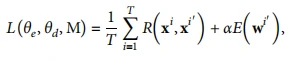
aquí está el hiperparámetro en el proceso de entrenamiento. En la práctica, se establece en 0.0002. En el proceso de entrenamiento, la memoria se actualiza mediante retropropagación y descenso de gradiente. En la retropropagación, solo el gradiente del elemento de memoria con un peso de direccionamiento distinto de cero puede ser distinto de cero.
2.4. Prueba. Después de entrenar el modelo, el error de reconstrucción del píxel en la posición (x, y) del marco de dientes t se puede calcular mediante la siguiente ecuación:
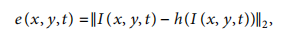
donde h(·) representa el modelo completo. Dado el error de reconstrucción a nivel de píxel del décimo fotograma, el error de reconstrucción de todo el fotograma de la imagen se puede obtener sumando e(t) � . (x, y) e (x, y, t). (es decir, la puntuación de anomalía del marco se puede calcular de la siguiente manera:
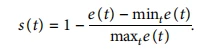
Finalmente, se puede establecer un umbral para determinar si es anormal cuando s(t) > θ.
3. Experimenta
En esta sección se verifica la efectividad del método propuesto y se compara con otros métodos existentes. En la actualidad, se utilizan dos conjuntos de datos públicos para experimentos, es decir, el conjunto de datos de Avenue y el conjunto de datos de ShanghaiTech. (El área de nivel de cuadro bajo la curva (AUC) y EER se utilizan como indicadores de evaluación cuantitativa.
3.1. Preparación. (El conjunto de datos de e Avenue usa una cámara fija con una resolución de 640 × 360 píxeles para capturar y registrar las actividades de la calle de la Universidad de la Ciudad de Hong Kong. (El conjunto de datos de Inteligencia computacional y neurociencia 3 incluye 16 clips de video de capacitación que contienen el comportamiento humano normal y 21 clips de video de prueba que contienen eventos anormales y comportamiento humano. Tiene un total de 30652 cuadros, y todos los videos de prueba tienen anotaciones a nivel de objetivo, es decir, se usa un área rectangular para marcar anomalías en ubicaciones espaciales. El comportamiento normal es gente caminando en el acera, mientras que los eventos anormales son personas que tiran basura/desechan artículos, deambulan, caminan hacia la cámara, caminan sobre el césped y descartan objetos (el conjunto de datos de ShanghaiTech es una colección muy desafiante para la detección de eventos anormales. A diferencia de otros conjuntos de datos, contiene 13 conjuntos de datos diferentes). escenas con diferentes condiciones de iluminación y ángulos de cámara, incluido un total de 330 videos de capacitación y 107 videos de prueba (el conjunto de prueba contiene un total de 130 eventos anormales con anotaciones a nivel de píxeles). (El conjunto de datos completo tiene un total de 316154 cuadros, incluidos 274515 cuadros en el conjunto de entrenamiento, 42883 cuadros en el conjunto de prueba y 17090 cuadros en el cuadro anormal. (La resolución de cada cuadro de video es 480 × 856. (El modelo es probado en una plataforma con plataforma de hardware NVIDIA GTX1080TI y memoria de video de 8 GB, y el entorno de software es PyTorch y Python 3.6 Para medir la efectividad del método para la detección de anomalías de video propuesto en este documento, el AUC del nivel de cuadro La curva característica operativa del receptor (ROC) se usa como índice de evaluación. Para los indicadores de evaluación a nivel de cuadro, si al menos un píxel de un cuadro se marca como anormal, el cuadro se considera anormal. Y el nivel de cuadro AUC se calcula comparando el resultado de detección de nivel de cuadro con el nivel de cuadro de la etiqueta real.
Principales componentes químicos de Cistanche deserticola
Haga clic aquí para ver los productos Cistanche
【Pregunte por más】 Correo electrónico:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
3.2. Configuración experimental. Todos los cuadros de video se ajustan a 227 × 227 y luego se convierten a imágenes en escala de grises. (La entrada del modelo es 227 × 227 × 5, es decir, se utilizan 5 fotogramas consecutivos como entrada del modelo. Después de cada capa convolucional, hay una capa de normalización por lotes y una capa de excitación ReLU. (Decodificador electrónico incluye 4 capas de desconvolución. (El módulo de atención está configurado para permitir que cada segmento de memoria registre una característica en un píxel en el mapa de características, correspondiente a una subregión del segmento de video. (Por lo tanto, el módulo de memoria es un 10 matriz de 00 × 64. (Se selecciona el optimizador de Adam para la optimización de todos los parámetros del modelo. (La tasa de aprendizaje inicial es 0,0001 y el número de iteraciones es 1000. (El parámetro de impulso es ρ1 � 0.9 y ρ2 � 0.999, y el tamaño del lote es 128.
3.3. Resultados experimentales. Con el fin de probar la efectividad del método propuesto en la detección de anomalías de video, este artículo lo compara con 12 métodos diferentes existentes. Entre ellos, MPPCA (híbrido de analizador probabilístico de componentes principales) más SF (poder social) [17] y MDT (híbrido de textura dinámica) [18] son métodos basados en características manuales; Conv-AE [8], 3D Conv [19], Stacked RNN [20] y ConvLSTM-AE [21], MemNormalality [10] y ClusterAE [22] son todos métodos basados en codificadores automáticos; AbnormalGAN [7] y Pred plus Recon [23] se basan en el método de generación de redes antagónicas. La Tabla 1 muestra los resultados de detección de anomalías de video a nivel de cuadro de varios métodos. Se puede observar que, en los resultados de los dos conjuntos de datos, el método basado en AE suele ser mejor que el método basado en características hechas a mano, y se obtienen AUC de nivel de cuadro más altas. (se debe a que las características hechas a mano generalmente se extraen en función de otras tareas y, por lo tanto, pueden ser subóptimas. En los métodos basados en AE, ConvLSTM-AE es mejor que Conv-AE porque el primero puede capturar mejor la información del tiempo. Además, también puede Tenga en cuenta que los métodos basados en GAN funcionan mejor que la mayoría de los métodos de referencia.Finalmente, el método Memory AE propuesto en este documento logra un 85,7 por ciento de AUC a nivel de cuadro en el conjunto de datos de Avenue, que es un 0,6 por ciento por delante del Pred plus Recon de mejor rendimiento. [23]; mientras que el método propuesto en este documento logró un 75,3 por ciento de AUC a nivel de cuadro en el conjunto de datos de ShanghaiTech, que está un 2 por ciento por delante de otros métodos en AUC a nivel de cuadro, y el efecto es muy obvio (principalmente porque el El método propuesto basado en Memory AE utiliza fragmentos de memoria, que pueden reconstruir bien las anomalías e introducir algunos errores aleatorios. Además, en comparación con el conjunto de datos de Avenue, el conjunto de datos de ShanghaiTech ha logrado un AUC de nivel de cuadro más alto. (principalmente porque el conjunto de datos de ShanghaiTech contiene múltiples escenas y eventos anormales que no han aparecido antes en otros conjuntos de datos, lo cual es más complicado. Para verificar los resultados de detección de una sola escena en el conjunto de datos de ShanghaiTech, se utiliza un segmento de video de una sola escena para entrenamiento y prueba. 83 segmentos (25 por ciento) se usan para entrenamiento y 34 segmentos (32 por ciento) se usan para prueba, logrando un 86.3 por ciento de AUC a nivel de cuadro, que alcanzó un nivel similar al del conjunto de datos de Avenue. En resumen, el método Memory AE propuesto se puede aplicar de manera flexible a diferentes tipos de datos. Solo utilizando errores de reconstrucción, el método propuesto puede obtener mejores resultados con el menor conocimiento específico. Para evaluar el rendimiento del módulo de memoria predefinido en la detección de eventos de video anormales, el siguiente paso es cambiar el tamaño del módulo de memoria y realizar experimentos en el conjunto de datos de Avenue, y los valores de AUC a nivel de cuadro se dan en la Tabla 2. Se puede encontrar que, dado un tamaño de módulo de memoria suficientemente grande, el método Memory AE puede producir los mejores resultados de manera sólida. Cuando el tamaño del módulo de memoria es superior a 1000, el impacto en el resultado de la detección es pequeño, pero el uso de un módulo de memoria de mayor tamaño dará como resultado una mayor cantidad de cálculos, por lo que el tamaño del módulo de memoria se selecciona como 1000. Cifras 2(a) y 2(b), respectivamente, muestran algunos resultados de detección en el conjunto de datos de Avenue y el conjunto de datos de ShanghaiTech. (e Tabla 1: Comparación con los métodos del estado del arte en términos de AUC.
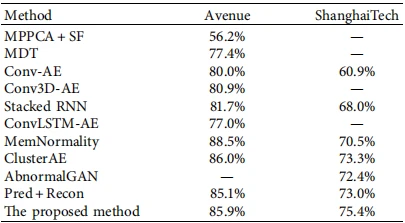
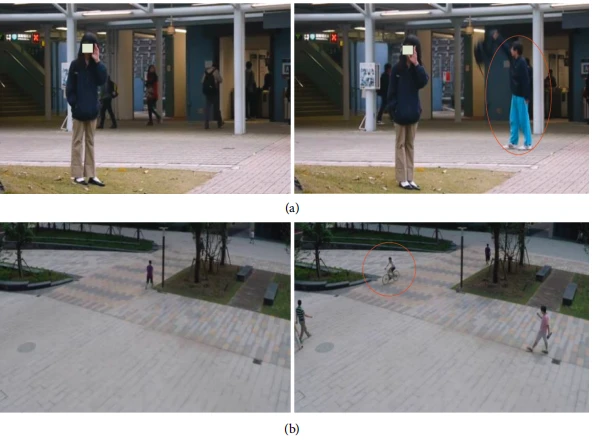
mejor que el método basado en características hechas a mano, y se obtienen AUC de nivel de cuadro más altas. (se debe a que las características hechas a mano generalmente se extraen en función de otras tareas y, por lo tanto, pueden ser subóptimas. En los métodos basados en AE, ConvLSTM-AE es mejor que Conv-AE porque el primero puede capturar mejor la información del tiempo. Además, también puede Tenga en cuenta que los métodos basados en GAN funcionan mejor que la mayoría de los métodos de referencia.Finalmente, el método Memory AE propuesto en este documento logra un 85,7 por ciento de AUC a nivel de marco en el conjunto de datos de Avenue, que es 0,6 por ciento por delante del el método Pred plus Recon [23] de mejor desempeño; mientras que el método propuesto en este documento logró un 75,3 por ciento de AUC a nivel de marco en el conjunto de datos de ShanghaiTech, que está un 2 por ciento por delante de otros métodos en AUC a nivel de marco, y el efecto es muy obvio (se debe principalmente a que el método propuesto basado en Memory AE utiliza fragmentos de memoria, que pueden reconstruir bien las anomalías e introducir algunos errores aleatorios. Además, en comparación con el conjunto de datos de Avenue, el conjunto de datos de ShanghaiTech ha logrado un AUC de nivel de marco más alto. (es principalmente porque el conjunto de datos de ShanghaiTech contiene múltiples escenas y eventos anormales que no han aparecido antes en otros conjuntos de datos, lo cual es más complicado. Para verificar los resultados de detección de una sola escena en el conjunto de datos de ShanghaiTech, se utiliza un segmento de video de una sola escena para entrenamiento y prueba. 83 segmentos (25 por ciento) se usan para entrenamiento y 34 segmentos (32 por ciento) se usan para pruebas, logrando 86.3 por ciento de AUC a nivel de cuadro, que alcanzó un nivel similar al del conjunto de datos de Avenue. En resumen, el método Memory AE propuesto se puede aplicar de manera flexible a diferentes tipos de datos. Solo utilizando errores de reconstrucción, el método propuesto puede obtener mejores resultados con el menor conocimiento específico. Para evaluar el rendimiento del módulo de memoria predefinido en la detección de eventos de video anormales, el siguiente paso es cambiar el tamaño del módulo de memoria y realizar experimentos en el conjunto de datos de Avenue, y los valores de AUC a nivel de cuadro se dan en la Tabla 2. Se puede encontrar que, dado un tamaño de módulo de memoria suficientemente grande, el método Memory AE puede producir los mejores resultados de manera sólida. Cuando el tamaño del módulo de memoria es superior a 1000, el impacto en el resultado de la detección es pequeño, pero el uso de un módulo de memoria de mayor tamaño dará como resultado una mayor cantidad de cálculos, por lo que el tamaño del módulo de memoria se selecciona como 1000. Cifras 2(a) y 2(b), respectivamente, muestran algunos resultados de detección en el conjunto de datos de Avenue y el conjunto de datos de ShanghaiTech. (Los cuadros en el cuadro verde son cuadros normales de videoclips regulares, y los cuadros en el cuadro rojo son cuadros anormales de clips de video anormales. Algunos eventos anormales como tirar confeti, andar en bicicleta en la acera, palizas, etc., pueden ser detectado.
Tabla 2: (e influencia del número de tamaño de memoria en los resultados experimentales del conjunto de datos de Avenue (AUC/porcentaje a nivel de marco).

Figura 2: Ejemplos de los resultados de detección. (a) Ejemplo del conjunto de datos Avenue. (b) Ejemplo del conjunto de datos de ShanghaiTech.
4. Conclusión
(Este documento propone un Memory AE para mejorar el rendimiento de la detección de anomalías de big data en videos. Dada una entrada, el método Memory AE propuesto primero usa un codificador para obtener una representación codificada y luego usa el código como una consulta para recuperar el más relevante patrones en el módulo de memoria para la reconstrucción Dado que el módulo de memoria está entrenado para registrar patrones normales típicos, la memoria AE propuesta puede reconstruir bien las muestras normales y aumentar el error de reconstrucción de las anomalías, lo que fortalece el papel del error de reconstrucción como un estándar de detección de anomalías. Los experimentos en dos conjuntos de datos demuestran la versatilidad y eficacia del método propuesto. En el futuro, estudiaremos el uso de pesos de direccionamiento para la detección de anomalías. Teniendo en cuenta que el módulo de memoria propuesto es universal y no tiene nada que ver con la estructura del codificador y decodificador, se integrará en un modelo básico más complejo y se utilizará en experimentos en conjuntos de datos más desafiantes.
Suplemento de Cistanche cerca de mí-Mejorar la memoria
Referencias
[1] F. Dong, Y. Zhang y X. Nie, "Red antagónica generativa de discriminador dual para la detección de anomalías de video", IEEE Access, vol. 8, págs. 88170–88176, 2020.
[2] K. Doshi y Y. Yilmaz, "Detección de anomalías secuenciales de cualquier disparo en videos de vigilancia", en Proceedings of the CVPRW, pp. 934-935, Seattle, WA, EE. UU., junio de 2020.
[3] K. Doshi y Y. Yilmaz, "Aprendizaje continuo para la detección de anomalías en videos de vigilancia", en Proceedings of the CVPRW, pp. 254-255, Seattle, WA, EE. UU., junio de 2020.
[4] K. Jayanta, "Dutta y bonny Banerjee. Detección en línea de eventos anormales usando longitud de codificación incremental", en Proceedings of the AAAI, pp. 3755–3761, Austin, Texas, EE. UU., enero de 2015.
[5] Y. Feng, Y. Yuan y X. Lu, "Aprendizaje de modelos de eventos profundos para la detección de anomalías de multitudes", Neurocomputing, vol. 219, págs. 548–556, 2017.
[6] D. Gong, L. Liu, V. Le et al., "Memorización de la normalidad para detectar anomalías: codificador automático profundo aumentado con memoria para la detección de anomalías no supervisadas", en Actas del ICCV, págs. 1705–1714, Seúl, Corea, octubre de 2019.
[7] M. Ravanbakhsh, M. Nabi, E. Sangineto, L. Marcenaro, C. Regazzoni y N. Sebe, "Detección de eventos anormales en videos usando redes antagónicas generativas", en Actas de la Conferencia internacional IEEE sobre procesamiento de imágenes , págs. 1577–1581, Pekín, China, septiembre de 2017.
[8] M. Hasan, J. Choi, J. Neumann, AK Roy-Chowdhury y LS Davis, "Aprendizaje de la regularidad temporal en secuencias de video", en Actas de la Conferencia IEEE sobre visión por computadora y reconocimiento de patrones, págs. 733– 742, Las Vegas, NV, EE. UU., junio de 2016.
[9] W. Liu, W. Luo, D. Lian y S. Gao, "Predicción de fotogramas futuros para la detección de anomalías: una nueva línea de base", en Actas de la Conferencia IEEE sobre visión artificial y reconocimiento de patrones, págs. 6536– 6545, Salt Lake City, UT, EE. UU., junio de 2018.
[10] H. Park, J. Noh y B. Ham, "Aprendizaje de la normalidad guiada por la memoria para la detección de anomalías", en Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, págs. 14 372–{{ 3}}, Seattle, WA, EE. UU., junio de 2020.
[11] MZ Zaheer, J.-h. Lee, M. Astrid y S.-I. Lee, "Old is gold: redefiniendo el paradigma de entrenamiento del clasificador de una clase aprendido por el adversario", en Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pp. 14 183–214 193, Seattle, WA, Estados Unidos, junio de 2020.
[12] X. Zhu, J. Liu, J. Wang, Y. Fang y H. Lu, "Detección de anomalías en la escena abarrotada a través del modelado conjunto de apariencia y dinámica", en Actas de la Conferencia internacional IEEE sobre procesamiento de imágenes, págs. 2705–2708, Melbourne, VIC, Australia, septiembre de 2013.
[13] RVHM Colque, CAC J´unior y WR Schwartz, "Histogramas de orientación y magnitud del compañero óptico para detectar eventos anómalos en videos", en Actas de la Conferencia Sibgrapi sobre gráficos, patrones e imágenes, págs. 126–133 , Salvador, Bahía, Brasil, agosto de 2015.
[14] Bo Zong, S. Qi, RM Martin, et al., "Modelo de mezcla gaussiana de codificación automática profunda para la detección de anomalías no supervisadas", en Actas de la Conferencia internacional sobre representaciones de aprendizaje, Vancouver, Canadá, abril de 2018.
[15] M. Sabokrou, M. Fayyaz, M. Fathy, Z. Moayed y R. Klette, "Anomalía profunda: red neuronal totalmente convolucional para la detección rápida de anomalías en escenas concurridas", Computer Vision and Image Understanding, vol. 172, págs. 88 y 97, 2018.
[16] C. Li, Z. Han, Q. Ye y J. Jiao, "Detección de comportamiento anormal visual basada en el análisis de reconstrucción escasa de trayectoria", Neurocomputing, vol. 119, núm. 7, págs. 94 a 100, 2013.
[17] V. Mahadevan, W. Li, V. Bhalodia y N. Vasconcelos, "Detección de anomalías en escenas llenas de gente", en Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), págs. 1975–1981, IEEE, San Francisco, CA, EE. UU., junio de 2010.
[18] W. Li, V. Mahadevan y N. Vasconcelos, "Detección y localización de anomalías en escenas llenas de gente", IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 36, págs. 18 a 32, 2014.
[19] Y. Zhao, B. Deng, C. Shen, Y. Liu, H. Lu y X.-S. Hua, "Codificador automático espacio-temporal para la detección de anomalías de video", en Proceedings of the ACM International Conference on Multimedia (ACM MM), págs. 1933–1941, ACM, Mountain View, California, EE. UU., octubre de 2017.
[20] W. Luo, L. Wen y S. Gao, "Una revisión de la detección de anomalías basada en codificación dispersa en el marco RNN apilado", en Actas de la Conferencia internacional IEEE sobre visión artificial (ICCV), Venecia, Italia, octubre 2017.
[21] W. Luo, L. Wen y S. Gao, "Recordando la historia con LSTM convolucional para la detección de anomalías", en Actas de la Conferencia Internacional IEEE sobre Multimedia y Exposición (ICME), págs. 439–444, IEEE, Hong Kong, julio de 2017.
[22] Y. Chang, Z. Tu, W. Xie y J. Yuan, "Codificador automático profundo impulsado por agrupamiento para la detección de anomalías de video", en Actas de la Conferencia Europea sobre Visión por Computador (ECCV), págs. 329–345, Springer, Glasgow, Reino Unido, agosto de 2020.
[23] L. Wen, W. Luo, D. Lian y S. Gao, "Predicción de fotogramas futuros para la detección de anomalías: una nueva línea de base", en Actas de la Conferencia IEEE sobre visión artificial y reconocimiento de patrones (CVPR), págs. 6536–6545, IEEE, Salt Lake City, UT, EE. UU., junio de 2018.
[24] M. Song, "Una vista de campo medio del paisaje de las redes neuronales de dos capas", Actas de la Academia Nacional de Ciencias, vol. 115, núm. 33, págs. E7665–E7671, 2018.
[25] B. Ding y G. Wen, "Restricción de escasez clasificador subespacial más cercano para el reconocimiento de objetivos de imágenes SAR", Journal of Visual Communication and Image Representation, vol. 52, págs. 170–176, 2018.
[26] T. Wang y H. Snoussi, "Detección de eventos visuales anómalos a través del histograma de orientación óptica global", IEEE Transactions on Information Forensics and Security, vol. 9, núm. 6, págs. 988–998, 2014.