Parte 1: Firmas genéticas distintas de las regiones corticales y subcorticales asociadas con la memoria humana
Mar 21, 2022
Contacto: Audrey Hu Whatsapp/hp: 0086 13880143964 Correo electrónico:audrey.hu@wecistanche.com
Pin Kwang Tan1, Egor Ananyev2 y Po-Jang Hsieh3
1 Instituto de Salud N.1, Universidad Nacional de Singapur, Singapur, Singapur 117456,
2 Departamento de Psicología, Universidad Tecnológica de Nanyang, Singapur, Singapur 639798,
3 Departamento de Psicología, Universidad Nacional de Taiwán, Ciudad de Taipei, Taiwán 10617
Por favor haga clic aquí para la Parte 2
Resumen
A pesar del descubrimiento de variantes genéticas vinculadas amemoriadesempeño, comprender la base genética de la memoria humana adulta sigue siendo un desafío. Aquí, diseñamos un marco no supervisado que se basa en las correlaciones espaciales entre los datos del transcriptoma humano y los mapas de neuroimagen funcional para descubrir las firmas genéticas dememoriaen estructuras corticales y subcorticales definidas funcionalmentememoriaregiones. Los resultados se validaron con literatura animal y mostraron que nuestro marco es altamente efectivo para identificar procesos y genes relacionados con la memoria en comparación con una función cognitiva de control. Los genes que se expresan preferentemente en las regiones de la memoria cortical están vinculados a procesos relacionados con la memoria, como la regulación inmunitaria y epigenética. Los genes expresados en regiones de memoria subcorticales están asociados con la neurogénesis y la diferenciación de células gliales. Los genes expresados en áreas de memoria tanto corticales como subcorticales están involucrados en la regulación de la transcripción, la plasticidad sináptica y la señalización del receptor de glutamato. Además, distintos genes asociados con la memoria, como PRKCD y CDK5, están vinculados a regiones corticales y subcorticales, respectivamente. Por lo tanto, las regiones de memoria corticales y subcorticales exhiben firmas genéticas distintas que potencialmente reflejan diferencias funcionales en la salud y la enfermedad, y nominan genes candidatos para futuras investigaciones experimentales.
Palabras clave: cognición; cortical; genético; humano; memoria; neuroimagen

Cistanche puede mejorar la memoria
Declaración de significado Los aspectos anatómicos y funcionales del ser humanomemoriaestán bien caracterizados, pero sus mecanismos biológicos son poco conocidos. Aquí, para descubrir las firmas genéticas asociadas con humanosmemoriafunción, analizamos las correlaciones espaciales entre la expresión génica a microescala y los mapas de neuroimagen a macroescala para derivarmemoria-procesos biológicos y genes relacionados de forma no supervisada. Descubrimos que las firmas genéticas de la memoria cortical y subcortical son en gran medida distintas y están asociadas conmemoria. Identificamos menos caracterizadomemoriagenes asociados también. Además, nuestro marco demostró eficacia y precisión en la identificación de firmas genéticas relacionadas conmemoriafrente a otra función como control. En general, nuestro trabajo proporciona un enfoque centrado en el ser humano para comprender la genética de la cognición e identifica posibles genes candidatos para futuras investigaciones experimentales.
Introducción
MemoriaLa función es crucial para la vida cotidiana, desde la aritmética mental hasta la planificación a largo plazo. HumanomemoriaLa función está bien caracterizada en términos de correlatos neurales asociados con el comportamiento y los trastornos mentales. Los conocimientos de fMRI y estudios de lesiones llevaron a una comprensión de las estructuras corticales y subcorticales.memoriaregiones como áreas funcionalmente distintas, subsumidas bajo el amplio paraguas de la función de la memoria (LaBar y Cabeza, 2006; Squire y Wixted, 2011). Sin embargo, a pesar del hecho de que la capacidad de memoria es altamente heredable, con factores de riesgo genéticos para los trastornos de la memoria, la firma genética subyacente a la memoria humana sigue sin comprenderse bien (Papassotiropoulos y de Quervain, 2011; Kandel et al., 2014; Freudenberg-Hua et al. , 2018). Nuestro conocimiento de los genes de la memoria humana se basa en gran medida en la variación interindividual de los genomas [p. ej., estudios de asociación del genoma completo (GWAS)] y la dinámica temporal a corto plazo de la función de la memoria (Berto et al., 2017). Sin embargo, existe un interés emergente en el uso de la dimensión espacial de la expresión génica para identificar perfiles genéticos de redes funcionales, mediante la integración de transcriptomas cerebrales humanos y mapas de neuroimagen (Yarkoni et al., 2011; Hawrylycz et al., 2012; Ritchie et al., 2018). Tales enfoques basados en patrones de expresión espacial pueden ayudar a responder una pregunta clave: ¿Existen genes asociados con regiones de memoria general en el cerebro humano adulto? Esto puede proporcionar una visión sin precedentes de los procesos biológicos y los genes asociados con la memoria humana, y proponer candidatos potenciales para futuras investigaciones experimentales.
Para identificar tales genes humanos adultos asociados con generalmemoria, confiamos en un método de correlación espacial (Fox et al., 2014). El método identifica genes asociados a la cognición que tienen una alta correlación espacial entre su expresión génica y un mapa de neuroimagen que representa la relevancia de cada área paramemoria(Fig. 1A,B). Este enfoque supone que los genes implicados enmemoriadebe estar altamente expresado en las áreas del cerebro altamente relevantes para la memoria. Por ejemplo, esta relación se observó en el caso del gen asociado a la recompensa DRD2 en áreas de procesamiento de recompensas (Mengod et al., 1992; Pappata et al., 2002; Schott et al., 2008). Para la expresión genética y los mapas funcionales, utilizamos el transcriptoma Allen Human Brain Atlas (AHBA) y el mapa de neuroimagen de "memoria" de Neurosynth.
Entonces identificamosmemoria-perfiles genéticos relacionados de manera no supervisada con análisis de enriquecimiento de conjuntos de genes (GSEA; Fig. 1C). Debido a la naturaleza correlacional del análisis de correlación espacial, recurrimos a bases de datos de conocimiento biológico (es decir, análisis de enriquecimiento con la biblioteca Gene Ontology) para guiar nuestra identificación de procesos biológicos y genes asociados con la memoria. Para identificar genes asociados a la memoria específicos de la corteza y de la subcorteza, comparamos las diferencias entre sus respectivos genes
Este trabajo fue apoyado por la Escuela de Medicina de Graduados de Duke-NUS y por el Programa de Jóvenes Académicos de Yushan NTU-108V0202.

Expresiones de gratitud: Agradecemos a Nilofer Husain y Wu Jinlu por sus comentarios sobre las primeras versiones de este manuscrito. Los datos fueron proporcionados por el Instituto Allen para la Ciencia del Cerebro y el depósito de Neurosynth.
La correspondencia debe dirigirse a Pin Kwang Tan en los perfiles (Fig. 1D). Como hay genes que están implicados en generalmemoriaa través de las regiones corticales y subcorticales (Gallo et al., 2018), también caracterizamos la superposición entre los perfiles genéticos corticales y subcorticales (Fig. 1D). Además, para identificar genes candidatos, identificamos los principales-10 genes más probablemente asociados conmemoriacon análisis de vanguardia (LEA; Fig. 1E). Luego validamos nuestros resultados al verificar que los perfiles genéticos corroboran con la literatura experimental. Finalmente, evaluamos si nuestro enfoque fue efectivo y preciso (Fig. 1F, G).
Por su participación común y crítica en generalmemoria, analizamos las áreas tanto corticales como subcorticales involucradas enmemoria. Es de destacar que los estudios previos sobre redes funcionales se centraron principalmente en análisis corticales o subcorticales debido a perfiles de expresión dispares. Esto puede deberse a marcadas diferencias en la composición neuronal, el número de capas y la conectividad (O'Leary y Koester, 1993; Yushkevich et al., 2009; Modha y Singh, 2010; Kim et al., 2015). A nivel genético, estas diferencias se reflejan en distintos patrones tanto de intensidad como de variabilidad de la expresión génica (Hawrylycz et al., 2012; Richiardi et al., 2015; Fox et al., 2014). Por lo tanto, analizamos sus correlaciones espaciales por separado, ya que la combinación de ambas en el análisis de correlación espacial capturaría las grandes diferencias cortico-subcorticales en la intensidad de la expresión en lugar de diferencias interregionales significativas en la expresión genética.
A pesar de una participación común en generalmemoria, encontramos procesos y genes biológicos relacionados con la memoria en gran medida distintos en las regiones corticales y subcorticales. Los procesos corticales incluyeron la regulación inmunitaria y epigenética; los procesos subcorticales incluyeron neurogénesis y diferenciación de células gliales. Los genes compartidos entre las regiones corticales y subcorticales estaban involucrados en la regulación de la transcripción, la plasticidad sináptica y la señalización del receptor de glutamato. Mostramos que nuestro enfoque identificó una mayor cantidad de genes de memoria en el análisis de memoria de lo esperado por casualidad, y más genes de memoria que genes de función motora. Estos resultados proporcionan una mejor comprensión de la genética asociada con la memoria humana y nominan genes candidatos para futuras investigaciones experimentales.
Materiales y métodos
transcriptoma AHBA
El transcriptoma AHBA se generó a partir del muestreo de micromatrices de ARNm normalizado de 3702 sitios de muestreo combinados en seis cerebros de donantes (Hawrylycz et al., 2012; N 6 hemisferios izquierdos, N 2 hemisferios derechos; Fig. 1A; ver Extended DataFig. {{5 }} para ver un ejemplo de visualización de un gen). Los donantes fueron tres hombres blancos, dos hombres afroamericanos y una mujer hispana. La edad de los donantes osciló entre 24 y 57 años, la edad media de los donantes fue de 42,5 años (DE 11,2 años). Los datos de los seis donantes se concatenaron horizontalmente en un archivo .csv, con una sonda por fila. Para obtener más detalles sobre el conjunto de datos y los procedimientos de recopilación de datos, consulte http://help.brain-map.org/display/ human brain/Documentation.
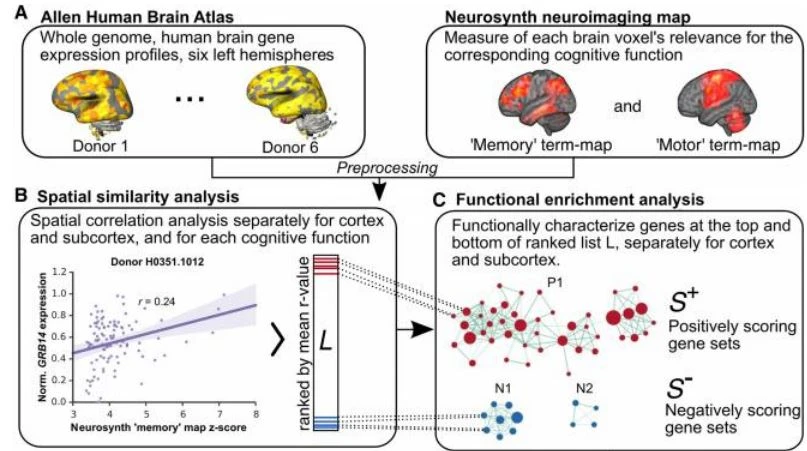
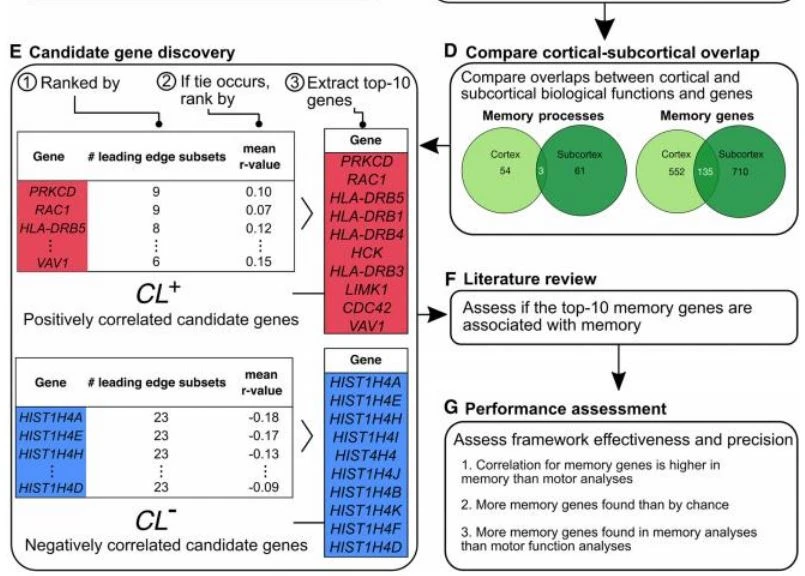
Figura 1. Descripción general del marco de descubrimiento de firmas genéticas. A, Los mapas de neuroimagen de AHBA y Neurosynth, y su preprocesamiento e integración en un espacio de plantilla de neuroimagen común. B, Cálculo de similitud espacial entre los mapas
por separado para las regiones corticales y subcorticales, y paramemoriay funciones motoras, derivando una lista de genes clasificados L por análisis (contiene genes y valor medio de r). C, Caracterización funcional de cada L con conjuntos de genes biológicamente significativos con análisis preclasificado de GSEA (las líneas punteadas que conectan L y los conjuntos de genes representan la agrupación de genes en conjuntos de genes enriquecidos), lo que produce conjuntos de genes de puntuación positiva y negativa S y S . D, Evaluación de las diferencias y la superposición entre cortical y subcorticalmemoriagenes E, Identificación de genes candidatos asociados con la función cognitiva y la región del cerebro, operacionalizados como el subconjunto de genes que impulsan la puntuación de enriquecimiento de los conjuntos de genes significativamente enriquecidos encontrados mediante el análisis de clasificación previa de GSEA. Esto produjo dos listas de genes candidatos, CL y CL, que contenían genes altamente correlacionados positiva y negativamente de S y S, respectivamente. F, Revisión de la literatura de cada CL cuantificando los genes asociados con la función cognitiva diana o de control. G, Evaluación de la validez y precisión del marco con cada uno de los ocho CL. Consulte la figura de datos extendida 1-1para una visualización de la expresión del gen GRB14 en AHBA, la figura de datos extendida 1-2para una visualización de los mapas de Neurosynth y la figura de datos extendida 1-3para las regiones corticales y subcorticales utilizadas en el análisis de correlación espacial.
Mapa de asociación de memoria de Neurosynth
Los mapas de asociación de "memoria" y "motor" de Neurosynth [Mon-treal Neurologic Institute 152 (MNI152) space, FDR con umbral 0.01] se utilizaron como datos de neuroimagen para lamemoriay funciones motoras (Fig. 1A; ver Extended DataFig. 1-2 para una visualización del Neurosynthmemoriay mapas motores). Estas funciones cognitivas se eligieron porque eran en gran medida funcional y anatómicamente distintas y se construyeron a partir de un número similar de estudios (memoria 2744, Nmotor 2565). Neurosynth cuantifica la relevancia de cada vóxel para los términos de búsqueda especificados por el usuario (p. ej., memoria) basándose en una base de datos de estudios de neuroimagen. En el ejemplo del mapa de memoria, a cada vóxel se le asigna una puntuación z que refleja la asociación preferencial de ese vóxel con la memoria, en lugar de otras funciones. Por ejemplo, la gran puntuación z positiva en el hipocampo significa que los estudios cuyos resúmenes incluyen la palabra memoria tienen más probabilidades de informar la participación del hipocampo que los estudios que no incluyen la palabramemoria(Yarkoni et al., 2011). Las puntuaciones z negativas indican una mayor correlación con otros términos de búsqueda no relacionados con la memoria y, por lo tanto, se excluyeron de nuestros análisis. Para dominios amplios de la función cognitiva, los términos individuales permiten la generación de mapas que se aproximan razonablemente bien al proceso cognitivo objetivo (Yarkoni et al., 2011). Por lo tanto, usamos memoria y motor como términos de búsqueda para derivar los mapas de asociación de memoria y motor. Tenga en cuenta que en el ejemplo de la memoria, este enfoque resultó en la inclusión de una amplia gama de subfunciones, como la memoria de trabajo y la memoria a largo plazo. Esto permitió una definición más amplia e inclusiva de la memoria y la función motora para la posterior identificación de sus firmas genéticas. En la generación de dichos mapas, es posible que los focos identificados por el proceso automático de extracción de coordenadas de Neurosynth sean inexactos debido a los diferentes formatos de datos de las revistas y sitios de neuroimagen en línea. Sin embargo, en comparación con el estándar de oro de los focos de activación seleccionados manualmente en la base de datos de sistemas de gestión de superficies (SumsDB), las coordenadas extraídas automáticamente muestran una alta sensibilidad (84 por ciento) y especificidad (97 por ciento; Yarkoni et al., 2011). Como tal, los mapas de memoria y neuroimagen motora utilizados son aproximaciones razonables de las regiones involucradas en la memoria general y la función motora.

Preprocesamiento del transcriptoma
atlas de Brodmann modificado utilizado por AHBA, y el hipocampo se volvió a etiquetar como una región subcortical en lugar de una región cortical de acuerdo con las convenciones de neuroimagen humana (Hawrylycz et al., 2012; Ji et al., 2019; lista de áreas corticales y subcorticales en Datos extendidos Fig. 1-3). En el preprocesamiento, las sondas se volvieron a anotar primero con el paquete Reannotator. Excluimos las sondas que tenían un 50 por ciento de muestras que superaban el nivel de expresión de fondo. Para cada gen, seleccionamos la sonda con la puntuación de estabilidad diferencial más alta, es decir, con la menor variabilidad espacial entre los donantes. Los datos de AHBA se normalizaron (puntuación z) para cada donante. Las regiones corticales y subcorticales se normalizaron por separado. Esto se hizo para tener en cuenta las diferencias individuales y corticosubcorticales en la expresión génica (Hawrylycz et al., 2011). Esto devolvió una matriz de muestra de cerebro de 15 625 genes por-1285 para la corteza izquierda y una matriz de 15{15}}por-497 para la subcorteza izquierda, respectivamente. Esto dio un promedio individual de 214 muestras corticales izquierdas (rango: 175-259) y 83 muestras subcorticales izquierdas por donante (rango: 59-115). En el siguiente paso a continuación, esto se restringió aún más a las regiones del cerebro de interés en el registro conjunto. Con el uso de un atlas cerebral diferente de AHBA, es posible que nuestra nueva anotación de regiones como áreas corticales o subcorticales sea inexacta y pueda afectar los análisis corticales y subcorticales. Sin embargo, como conservamos las etiquetas ontológicas de AHBA y simplemente volvimos a anotar el hipocampo como subcorteza, este paso es razonable.
Registro conjunto de AHBA y el mapa de memoria de Neurosynth
Para permitir una comparación de la similitud espacial entre la neuroimagen y los mapas AHBA de diferentes resoluciones, ambos mapas se registraron conjuntamente en un espacio cerebral estereotáctico 3D común (Fox et al., 2014). Esto se hizo utilizando las coordenadas MNI proporcionadas por AHBA para representar los puntos de muestreo del transcriptoma en el espacio de la plantilla MNI152. Este fue también el espacio utilizado por el mapa de Neurosynth. El mapa de Neurosynth se utilizó como máscara para el mapa AHBA, de modo que solo las áreas superpuestas se incluyeron en el análisis de correlación (Fox et al., 2014). Debido a la disponibilidad limitada de hemisferios muestreados (seis hemisferios izquierdos y dos derechos), utilizamos solo los hemisferios izquierdos, separados en regiones corticales y subcorticales. En pasos posteriores, los análisis corticales y subcorticales se mantuvieron separados. Además de proporcionar información sobre los mecanismos genéticos corticales y subcorticales separados, esto también evitó las confusiones de sus perfiles transcripcionales divergentes (Richiardi et al., 2015). Luego igualamos el suavizado de ambos mapas suavizando el AHBA con una esfera de 6 mm de radio. Al final de este paso, quedaban en promedio 93memoria(rango: 72–107)
y 65 puntos de datos corticales motores (rango: 55–76), y en promedio 40memoria(rango: 25-71) y 43 puntos de datos subcorticales motores (rango: 24-69) por individuo. Es posible que el registro conjunto de mapas de AHBA y Neurosynth se vea afectado por errores introducidos durante la transformación de coordenadas MRI a MNI por AHBA. Sin embargo, el Instituto Allen transformó las coordenadas MRI a MNI
utilizando métodos estándar para incranio y cerebros de excreción (se tomaron imágenes de cuatro cerebros de donantes ex craneo), y aseguramos un corregistro razonable mediante la inspección visual de los mapas resultantes.
Análisis de correlación espacial de datos de AHBA y Neurosynth
Para obtener valores de correlación espacial por gen, nos basamos en una herramienta que correlaciona el AHBA espacial y los mapas de neuroimagen (Yarkoni et al., 2011; Fox et al., 2014). Cada punto de datos utilizado en la correlación es un punto en el espacio, con un valor de intensidad de expresión génica normalizado y una puntuación z del mapa de neuroimagen. Para un gen asociado conmemoria, esperaríamos una gran similitud espacial entre los mapas de AHBA y Neurosynth, es decir, un patrón de alta expresión génica dentro de áreas muy relevantes para la memoria y viceversa. Esto se reflejaría en un valor de correlación medio alto para ese gen. Aplicamos el análisis espacial por separado para las regiones corticales y subcorticales (Fig. 1B). Se utilizó un análisis de efectos aleatorios aproximados para tener en cuenta la variabilidad de la expresión génica individual y para contrarrestar el escaso muestreo cortical en los mapas AHBA. La pendiente y el intercepto de la regresión de donantes se modelaron individualmente. Posteriormente, obtenemos el valor de correlación medio de cada gen (promediado entre los seis donantes), que fue la estadística de interés. De este paso, obtuvimos cuatro listas L de 15.625 genes, pormemoriay la función motora, y las respectivas regiones corticales y subcorticales.
Identificar los procesos biológicos de la memoria cortical y subcortical
Utilizamos una herramienta de análisis de conjuntos de genes (GSEA Pre-ranked, módulo GenePattern, versión 6.0.5) para identificar conjuntos de genes asociados con funciones biológicas comunes (Fig. 1C). Las cuatro listas de genes L se clasificaron por valor de correlación medio (la estadística de clasificación utilizada en este caso) y se pasaron a GSEA Pre-ranked. Analizamos cada lista L con GSEA clasificada previamente con los parámetros predeterminados, incluida la puntuación ponderada utilizando la biblioteca de procesos biológicos de ontología génica (c5.bp.v6.0.symbols.gmt). La clasificación previa de GSEA busca por separado en la parte superior e inferior de cada lista L los genes que se superponen con cada conjunto de genes en la base de datos (Mootha et al., 2003; Subramanian et al., 2005). Esta superposición o enriquecimiento del conjunto de genes se evaluó mediante puntuación ponderada basada en la correlación media (valor r). Esto devuelve una puntuación de enriquecimiento normalizada, un valor p significativo y un valor q de FDR (en todos los conjuntos de genes probados)
para cada conjunto de genes enriquecido. De los principales genes correlacionados positiva y negativamente en cada lista L, obtuvimos conjuntos separados S y S de conjuntos de genes enriquecidos positiva y negativamente, respectivamente. Para análisis posteriores, solo usamos todos los conjuntos de genes con FDR q {{0}}.05. Tenga en cuenta que el análisis de la corteza motora (-) (genes correlacionados negativamente del análisis de la corteza motora) no tuvo ningún conjunto de genes que sobreviviera a FDR 0.05 y, por lo tanto, no se usó en análisis posteriores, es decir, procesos biológicos ni genes candidatos como resultado. Por lo tanto, esto significó efectivamente ocho S y siete S conjuntos utilizables para los pasos posteriores. Para este análisis y los pasos subsiguientes, los genes que se encuentran en 1 conjunto de genes significativamente enriquecido se denominanmemoriagenes, a diferencia de los principales-10 genes de memoria identificados a continuación.
Visualización de conjuntos de genes significativamente enriquecidos
Identificar los temas biológicos generales en los conjuntos de genes. agrupamos conjuntos de genes en redes por los genes que comparten (Fig. 1C). Para cada par de conjuntos S y S, ingresamos sus conjuntos de genes en el software de visualización de redes Cytoscape e incluimos los conjuntos de genes con FDR q 0.05. Luego usamos la aplicación Enrichment Map para construir las redes de conjuntos de genes y las anotamos con la extensión Wordcloud para su interpretación posterior (Cline et al., 2007;Merico et al., 2010;Oesper et al., 2011 ). Esto se hizo usando la configuración predeterminada excepto por un umbral de valor de FDR q personalizado de 0,05 (es decir, FDR 0,05). Este paso devolvió cuatro mapas de enriquecimiento anotados para la lista L de cada función cognitiva y para cada una de las áreas corticales y subcorticales.
Anotación funcional de genes superpuestos
Usamos la suite ToppGene (con la biblioteca Gene Ontology Biological Process) para agrupar funcionalmentememoriagenes (identificados en el análisis GSEA) que son (1) específicos de la corteza, (2) específicos de la subcorteza, (3) y compartidos entre ambos (Fig. 1D; Chen et al., 2009). A partir de la salida, determinamos los conjuntos de genes de procesos biológicos como aquellos que satisfacían FDR 0.05. Esto devolvió tres listas de conjuntos de genes, uno para cada tipo de gen anterior.

Identificación de genes candidatos asociados con la memoria cortical y subcortical
Para identificar los genes principales{{0}} con mayor probabilidad de ser relevantes para la función cognitiva, identificamos genes que aparecen con frecuencia en los conjuntos de genes con LEA (Fig. 1E; Mootha et al., 2003; Subramanian et al. al., 2005). Para el análisis de cada función cognitiva en regiones corticales y subcorticales, ingresamos los conjuntos de genes respectivos con FDR q 0.05 (aplicación de escritorio javaGSEA). LEA luego identificó los genes que aparecían con frecuencia en los genes del subconjunto de vanguardia en los conjuntos de genes en S o S (Subramanian et al., 2005; Fleming y Miller, 2016). Clasificamos los genes por el número de conjuntos de genes de vanguardia que enriquecen; en el caso de un empate en el número de conjuntos de genes, los clasificamos por el valor medio de correlación espacial. Los principales-10 genes que aparecían con mayor frecuencia en los conjuntos de genes enriquecidos positiva y negativamente se designaron como la lista de genes candidatos CL. Los resultados fueron listas de asociaciones de cognición de genes CL de siete candidatos de 10 genes cada una para todos los S y S.