

Una nueva DBNet difusa para la segmentación de imágenes médicas, parte 1
Sep 15, 2023
Abstracto:Cuando los médicos están fatigados, a menudo cometen errores de diagnóstico. De manera similar, los farmacéuticos también pueden cometer errores al dispensar medicamentos. Por lo tanto, la segmentación de objetos desempeña un papel vital en muchas áreas relacionadas con la atención sanitaria, como el análisis de síntomas en imágenes biomédicas y la clasificación de fármacos. Sin embargo, muchos algoritmos tradicionales de aprendizaje profundo utilizan una vista única de una imagen para segmentar o clasificar. Cuando la imagen es borrosa o incompleta, estos algoritmos no logran segmentar con precisión el área patológica o la forma de los medicamentos, lo que puede afectar los planes de tratamiento posteriores. En consecuencia, proponemos Fuzzy DBNet, que combina la red de mariposa dual y el ASPP difuso en una red de aprendizaje profundo y procesa imágenes de ambos lados de un objeto simultáneamente. Nuestros experimentos utilizaron conjuntos de datos de rayos X de pulmones y píldoras de múltiples categorías para el entrenamiento. El coeficiente Dice promedio de nuestro modelo propuesto alcanzó el 95,05% en la segmentación de múltiples píldoras y el 97,05% en la segmentación pulmonar. Los resultados mostraron que nuestro modelo propuesto superó a otras redes de última generación en ambas aplicaciones, lo que demuestra que nuestro modelo puede usar múltiples vistas de una imagen para obtener segmentación o identificación de imágenes.
Cistanche puede actuar como antifatiga y potenciador de la resistencia, y estudios experimentales han demostrado que la decocción de Cistanche tubulosa podría proteger eficazmente los hepatocitos hepáticos y las células endoteliales dañadas en ratones nadadores que soportan peso, regular positivamente la expresión de NOS3 y promover el glucógeno hepático. síntesis, ejerciendo así eficacia antifatiga. El extracto de Cistanche tubulosa rico en glucósidos feniletanoides podría reducir significativamente los niveles séricos de creatina quinasa, lactato deshidrogenasa y lactato, y aumentar los niveles de hemoglobina (HB) y glucosa en ratones ICR, y esto podría desempeñar un papel antifatiga al disminuir el daño muscular. y retrasar el enriquecimiento de ácido láctico para el almacenamiento de energía en ratones. Las tabletas compuestas de Cistanche Tubulosa prolongaron significativamente el tiempo de natación con carga de peso, aumentaron la reserva de glucógeno hepático y disminuyeron el nivel de urea sérica después del ejercicio en ratones, mostrando su efecto antifatiga. La decocción de Cistanchis puede mejorar la resistencia y acelerar la eliminación de la fatiga en ratones que hacen ejercicio, y también puede reducir la elevación de la creatina quinasa sérica después del ejercicio de carga y mantener normal la ultraestructura del músculo esquelético de los ratones después del ejercicio, lo que indica que tiene los efectos. de potenciación de la fuerza física y antifatiga. Cistanchis también prolongó significativamente el tiempo de supervivencia de los ratones envenenados con nitritos y mejoró la tolerancia contra la hipoxia y la fatiga.
Haga clic en fatiga extrema
【Para más información:george.deng@wecistanche.com / WhatsApp:8613632399501】
1. Introducción
Ha habido numerosos casos en los que la segmentación de imágenes en medicina se ha implementado principalmente porque la interpretación de imágenes médicas de tomografías computarizadas y resonancias magnéticas requiere tiempo y conocimientos médicos sustanciales. Además, las estadísticas revelan que los errores médicos contribuyen a la muerte de entre 7.000 y 9.000 personas anualmente en los Estados Unidos [1]. Por lo tanto, para abordar estos problemas, se han propuesto varias soluciones tecnológicas. Por ejemplo, la U-Net desarrollada por Ronneberger et al. [2] se utiliza en la segmentación de imágenes biomédicas. El DoubleU-Net empleado por Debesh Jha et al. [3] se utiliza en procedimientos como la colonoscopia. Se basa principalmente en U-Net y VGG-19, compuestos por dos codificadores y decodificadores. De manera similar, Chin et al. [4] utilizan el algoritmo de aprendizaje profundo Mask R-CNN para segmentar las cuerdas vocales y las regiones de la glotis a partir de vídeos de laringe, lo que ayuda a los médicos en el diagnóstico y el tratamiento.
Entre el reconocimiento de imágenes pulmonares, Jakub et al. Señaló que los vasos sanguíneos ocluyen fácilmente los resultados de las imágenes de rayos X de las lesiones de la enfermedad. Aunque los métodos de aprendizaje automático para el reconocimiento de imágenes pulmonares pueden ayudar a reducir la carga del personal médico, su precisión es sólo del 91 % [5]. Además, el modelo de aprendizaje profundo para la identificación de enfermedades pulmonares ha demostrado ser superior a los métodos tradicionales de aprendizaje automático [6,7]. Por lo tanto, utilizamos el aprendizaje profundo para el reconocimiento de imágenes. En el caso de toracostomía por neumotórax, el médico debe observar la imagen de radiografía de tórax para encontrar la línea pleural translúcida que se superpone a las costillas. Debido a que esta imagen tiende a desdibujarse debido a la superposición de tejidos, el reconocimiento de imágenes tradicional no es efectivo [8], especialmente porque el aire se acumula en la parte frontal del cuerpo en lugar de en la parte superior, lo que dificulta a los médicos interpretar las áreas de neumotórax. Debido a que los síntomas iniciales de muchas lesiones pulmonares no son obvios y los pulmones tienen características patológicas complejas [9], muchos académicos han propuesto métodos de aprendizaje profundo para mejorar la precisión y eficiencia del diagnóstico [10]. Laura et al. [11] propusieron una red compleja para el reconocimiento de imágenes pulmonares y su experimento mostró una alta precisión para el reconocimiento de texturas. En consecuencia, un método de red complejo puede extraer características importantes. Alhassan et al. [12] utilizaron el método de aprendizaje conjunto para detectar neumonía en imágenes de rayos X de tórax con una tasa de precisión mejorada del 93%. Según las características de aprendizaje del conjunto, el método se utiliza para mejorar la precisión de la identificación del modelo. Mohamed et al. [13] propusieron un modelo de aprendizaje profundo para ayudar a la detección temprana de COVID-19, que ayudó al personal médico a reducir su carga de trabajo. Para la segmentación de imágenes pulmonares, Feidao et al. [14] propusieron un mecanismo de atención de tres terminales para resaltar el área objetivo automáticamente y mejorar el rendimiento de la segmentación pulmonar. Como resultado, se utiliza un módulo de puerta de atención para mejorar el efecto de entrenamiento del modelo. Sin embargo, estos modelos no utilizaron completamente las imágenes de radiografías de tórax. Hay dos modos para tomar imágenes de rayos X de pulmón: anteroposterior y posteroanterior. Las radiografías anteroposteriores de los pulmones se toman de la cavidad torácica; Las radiografías posteroanteriores del pulmón se toman desde la parte posterior. Los modelos de aprendizaje profundo existentes solo pueden ingresar una imagen a la vez para su reconocimiento [15]. Por lo tanto, es posible que el modelo no pueda identificar la ubicación de la lesión ya que solo se ingresa un lado de la imagen de rayos X [16]. En consecuencia, utilizamos métodos de aprendizaje profundo para la identificación de imágenes pulmonares.

Entre el reconocimiento de imágenes de píldoras, la mayoría de los métodos de clasificación existentes se basan únicamente en información unilateral, pero en algunos casos, muchos tipos de píldoras no se pueden clasificar. Por ejemplo, el mismo tipo de pastilla puede tener diferentes formas cuando se ve desde diferentes ángulos; algunas pastillas pueden tener letras en un solo lado; y aquellos con formas y colores similares también pueden suponer un desafío. En tales casos, es posible que el modelo no pueda clasificar un grupo de píldoras con precisión. Debido a la pandemia, un gran número de personas acuden a los hospitales todos los días, lo que genera un aumento sustancial en el uso de pastillas y errores médicos [17,18]. Para abordar estos problemas, Ou et al. [19] propusieron una arquitectura de aprendizaje profundo de dos etapas para detectar y posteriormente clasificar 1000 tipos de píldoras. Además, mejorar el conocimiento sobre los medicamentos y proporcionar a los pacientes información adecuada se han convertido en cuestiones importantes para evitar el desperdicio de medicamentos y los efectos secundarios nocivos [20]. Sin embargo, la identificación de las pastillas basada en la apariencia sigue siendo una tarea desalentadora para los pacientes. Wang y cols. [21] utilizó GoogLeNet Inception Network para entrenar arquitectura de aprendizaje profundo y técnicas de mejora de imágenes centrándose en el color, la forma y las marcas, pero solo puede identificar un único tipo de píldora, que es su gran defecto. La identificación simultánea de múltiples tipos de píldoras puede satisfacer mejor las necesidades del público. En el campo de la segmentación de imágenes de pastillas, Kwon et al. [22] utilizaron Mask R-CNN y los conjuntos de datos de entrenamiento que utilizaron contenían solo 27 tipos de píldoras, cada una de las cuales tenía diferentes formas y colores. En realidad, sin embargo, hay muchos más tipos de píldoras que tienen una apariencia similar. Para satisfacer las necesidades del mundo real, se utilizaron 93 tipos de píldoras para entrenar nuestro modelo. Tenían formas y colores similares y variaban principalmente en diferentes impresiones, lo que hacía que nuestro modelo fuera más aplicable a las necesidades clínicas. En la detección de objetos de pastillas, Lu et al. [23] propusieron muchos métodos de detección de objetos. Aunque estos modelos detectaron la posición de las pastillas, el mapa es solo del 87%. Además, los estudiosos anteriores no han abordado eficazmente los problemas de identificación de las píldoras, incluida su ubicación aleatoria y la presencia de varias píldoras en una imagen. El ángulo de rotación de la píldora también es difícil de determinar y estandarizar para cada clase de píldora.
Para la visión por computadora, en otros casos se utilizan vehículos aéreos no tripulados (UAV) combinados con aprendizaje profundo, Keiller et al. [24] estudiaron la clasificación de plantas desde perspectivas espaciales y espectrales utilizando imágenes RGB y UAV espectrales basadas en tecnología 2D-CNN.
Los métodos actuales para la segmentación de imágenes utilizan principalmente una sola imagen como entrada. Cuando se introduce una única imagen de baja calidad en el modelo, surgen problemas de segmentación y clasificación imprecisas de objetos. En el campo médico, debido a las características complejas de las imágenes, Akinobu et al. [25] propusieron BtrflyNet para identificar metástasis óseas, que puede aceptar dos imágenes de entrada simultáneamente. Los resultados experimentales indicaron que puede mejorar la tasa de éxito del entrenamiento de modelos. Sin embargo, este modelo sólo es aplicable a imágenes de metástasis óseas. Con base en este artículo, mejoramos BtrflyNet para proponer Fuzzy DBNet, que ha logrado excelentes resultados en el reconocimiento de imágenes de píldoras y de pulmones.
2. Materiales y métodos
2.1. Conjuntos de datos
En este artículo, se utilizaron conjuntos de datos de píldoras y radiografías de tórax. Los datos de las radiografías de tórax se obtuvieron del conjunto de datos de radiografías de tórax de los NIH [26] que contiene 112.120 imágenes, de las cuales extrajimos 72.324 de las vistas anteroposterior (AP) y posteroanterior (PA) de los mismos pacientes. Luego emparejamos las imágenes AP con sus correspondientes imágenes PA, lo que resultó en un total de 267,105 pares AP-PA después del aumento.

El conjunto de datos de la píldora comprende 93 categorías con un total de 1238 imágenes: redondas, ovaladas, rectangulares, triangulares y de diferentes colores. Para capturar ambos lados de cada píldora, se tomaron imágenes después de que las píldoras se esparcieran en un tablero transparente y se fotografiaran directamente desde arriba y desde abajo. Luego, el conjunto de datos se dividió en un 80 % para capacitación, un 10 % para pruebas y un 10 % para validación. Para mejorar la precisión del modelo, aplicamos el esquema AutoAugment [27] para discretizar cada magnitud de operación (M) de [0, 10] para el aumento de datos, lo que resultó en un conjunto de datos aumentado de 2476 imágenes.
El conjunto de datos fue la limitación más importante de nuestro modelo. En primer lugar, nuestras imágenes de entrada tenían que ser de doble cara, no sólo imágenes generales sino también imágenes que penetraran objetos, como los rayos X. En segundo lugar, se requerían correspondencias fijas de las posiciones de los objetos en las imágenes. Para solucionar esto, nuestro equipo se esforzó por alinear las posiciones de las píldoras entre sus imágenes de doble cara durante la recopilación del conjunto de datos.
Es importante señalar que el conjunto de datos de rayos X de pulmón utilizado en este estudio fue proporcionado por los NIH, mientras que el conjunto de datos de la píldora fue capturado por la fotografía de nuestro equipo.
2.2. Preprocesamiento de datos
Para ayudar a los farmacéuticos en la clasificación de las pastillas, se anotaron 93 tipos de pastillas. Usamos el anotador de imágenes VGG [28] para etiquetar cada una con su nombre en 93 categorías diferentes. Etiquetamos el borde de la píldora y convertimos los datos etiquetados en un archivo JSON como la verdad fundamental de los datos de entrenamiento. El algoritmo de preprocesamiento se puede encontrar en el Algoritmo A1.

2.3. DBNet difuso
Este artículo propone una nueva arquitectura de aprendizaje profundo, Fuzzy Double-Butterfly Network (DBNet), en la que se pueden ingresar dos imágenes con propiedades complementarias para realizar la segmentación de imágenes. Se compone principalmente de tres partes: arquitectura de codificador-decodificador de doble mariposa, bloque Fuzzy Atrous Spatial Pyramid Pooling (ASPP) y una puerta de atención, como se muestra en la Figura 1.
Se utilizó un VGG 19 entrenado para codificar la primera arquitectura de mariposa para extraer características de la imagen para ahorrar tiempo de entrenamiento y evitar el sobreajuste. Entre los dos codificadores y decodificadores con forma de mariposa, había dos bloques concatenados que conectaban dos conjuntos de bloques Fuzzy ASPP, intercambiando así las diferentes características de las imágenes. Luego, el resultado inicial generado por la primera arquitectura en forma de mariposa se multiplicó con la imagen original como se muestra en el bloque multiplicado en la Figura 1. Esto mejoró la gravedad específica de la característica para lograr una segmentación más precisa. El algoritmo Fuzzy DBNet se puede encontrar en el Algoritmo A2.
Fuzzy ASPP combinó ASPP con la teoría difusa y se colocó entre el codificador y el decodificador de las dos redes tipo mariposa. La Figura 2 muestra la estructura de Fuzzy ASPP.
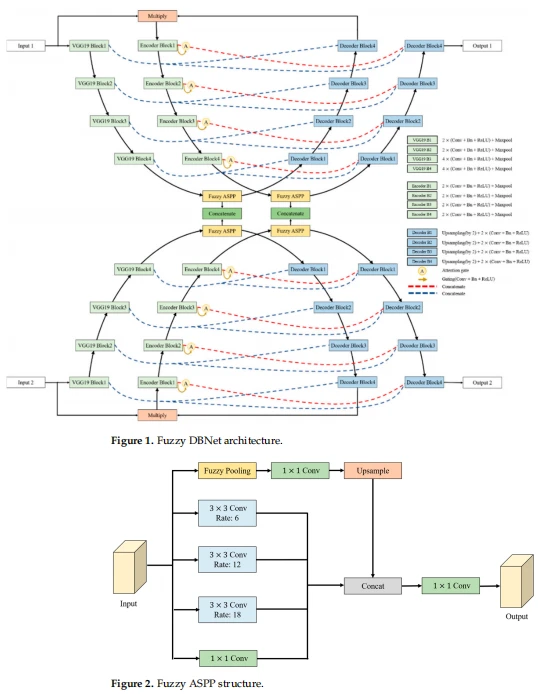
En la parte de Fuzzy Pooling, se utilizó una función de membresía en forma de campana para completar la operación y los resultados de cada parche de agrupación se ajustaron dinámicamente. El algoritmo A3 muestra el algoritmo de ajuste dinámico. El objetivo principal era reducir la proporción de la característica influenciada por factores de incertidumbre. El algoritmo Fuzzy ASPP se puede encontrar en el Algoritmo A4.
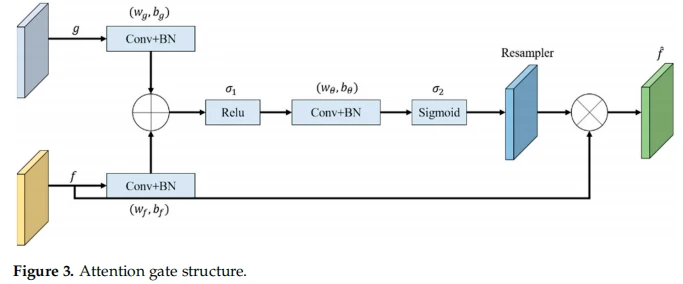
En las conexiones de salto, se utilizó un mecanismo de atención para eliminar respuestas ruidosas e irrelevantes mediante el uso de características extraídas de mapas de características más burdos. Redujo efectivamente el ruido y las características innecesarias en el modelo y mejoró su rendimiento y precisión. La Figura 3 muestra la estructura de la puerta de atención.
3. Resultado
3.1. Configuración del experimento
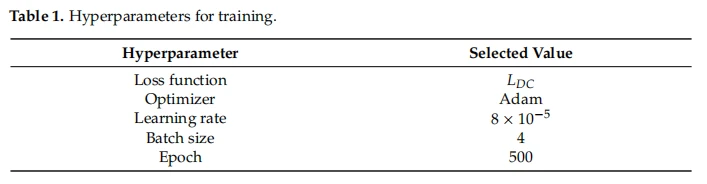
La validación del entrenamiento y las pruebas del modelo propuesto se realizaron en una computadora con un 8-CPU central (Intel Xeon W-3223), 64 GB de memoria, una GPU (RTX 3090) con 24 GB de memoria gráfica, y 10.496 núcleos CUDA. La implementación se realizó utilizando el marco PyTorch. La Tabla 1 muestra los hiperparámetros utilizados para todos los experimentos.
La función de pérdida total (LDC) combina la pérdida de dados promediada (LavgDice) con la pérdida de entropía cruzada categórica (LCCE) y se calcula de la siguiente manera:
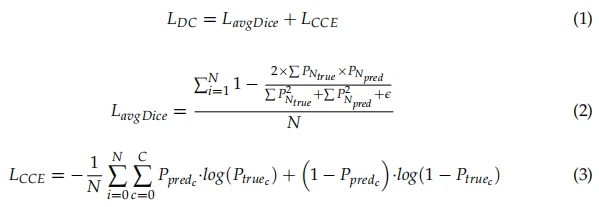
donde N es el número de muestras y C es el número de clases. Dado que la salida de la red fueron imágenes de clases múltiples, calculamos el LCCE usando la Ecuación (3). Luego, calculamos el LDice para cada clase usando la Ecuación (2). Fue posible poner a cero todos los píxeles en Ppred que no estaban activos en Ptrue. Para los píxeles activados, las predicciones de baja confianza fueron penalizadas en su mayoría, mientras que los valores de predicción más altos obtuvieron coeficientes Dice más altos. Por lo tanto, el modelo aprendió objetos de diferentes clases y tamaños a través de LDice y LCCE.
3.2. Índice de evaluación del desempeño
En este estudio, utilizamos tres métricas para evaluar el rendimiento del modelo: precisión de píxeles, coeficiente de dados promediado (Dice) e intersección media sobre unión (me). Estos indicadores se muestran en la siguiente fórmula.
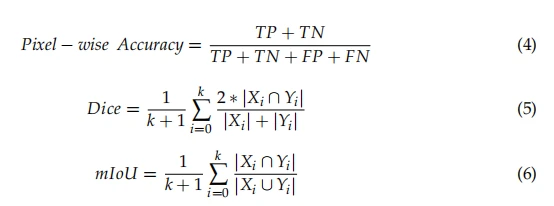
donde Xi denota los valores de verdad fundamentales y Yi denota los valores predichos. TP, FP, TN y FN representan los números de casos de verdaderos positivos, falsos positivos, verdaderos negativos y falsos negativos, respectivamente. La precisión de píxeles midió el porcentaje de píxeles identificados correctamente en la imagen; la puntuación de Dice midió la superposición entre la segmentación prevista y la verdad fundamental; y mIoU midió la segmentación predicha con la verdad fundamental. Se eligieron estas métricas porque proporcionaban una visión integral del rendimiento del modelo y permitían comparaciones significativas con otros modelos en el campo. Los valores más altos para estas métricas indicaron un mejor rendimiento del modelo.
3.3. Segmentación de imágenes de rayos X de pulmón
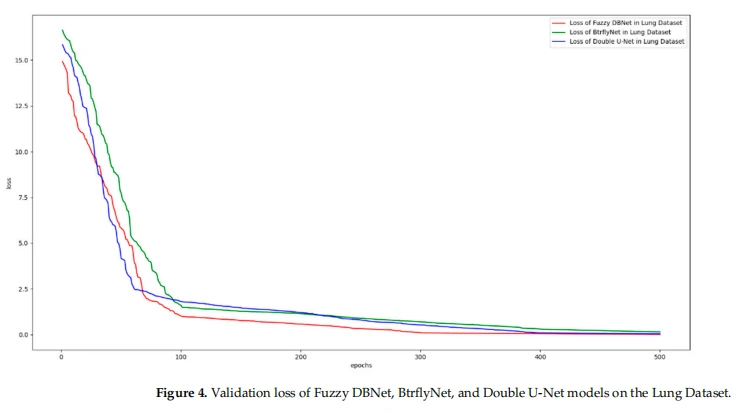
Realizamos experimentos para entrenar el método propuesto y validamos el modelo utilizando un conjunto de validación. Como se muestra en la Figura 4, la pérdida de entrenamiento de Fuzzy DBNet en el conjunto de datos de rayos X de pulmón alcanzó la convergencia alrededor de la época número 100 y logró una convergencia completa aproximadamente en la época 300.
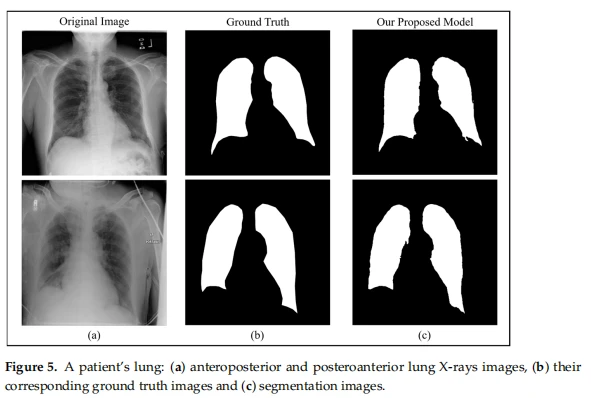
En el conjunto de datos de rayos X de pulmón, seleccionamos un conjunto de imágenes como ejemplos para las pruebas del modelo. Constaba de seis imágenes: imágenes sin procesar anteroposterior y posteroanterior, las imágenes reales correspondientes y los resultados segmentados. Estas imágenes se muestran en la Figura 5.
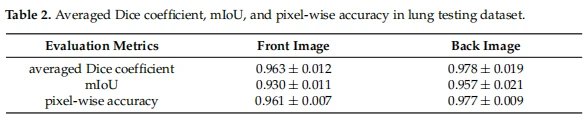
Comparamos los resultados de Fuzzy DBNet y su verdad fundamental en los datos de prueba utilizando el coeficiente Dice promedio, mIoU y precisión de píxeles para medir el rendimiento del modelo. Los resultados se muestran en la Tabla 2.
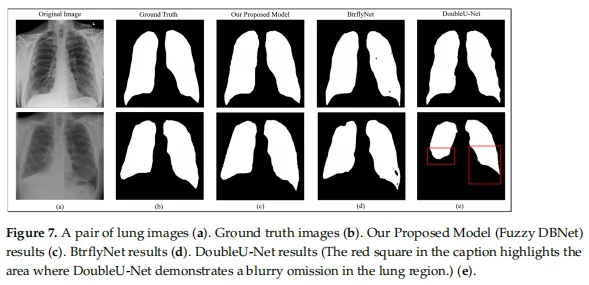
Seleccionamos dos conjuntos de radiografías de pulmón de los resultados de segmentación de nuestro conjunto de pruebas como ejemplos. En la Figura 6, la integridad de la segmentación de nuestro modelo fue mucho mejor que la de BtrflyNet. En la Figura 7, cuando las imágenes de los pulmones originales estaban borrosas, el rendimiento de segmentación de DoubleU-Net fue deficiente, mientras que nuestro modelo segmentó los pulmones con precisión.

【Para más información:george.deng@wecistanche.com / WhatsApp:8613632399501】


