

Reconocimiento del habla de vocales a partir de electroencefalografía de ratas utilizando una red neuronal de memoria a corto plazo, parte 3
Dec 28, 2023
Clasificadores de aprendizaje automático
El rendimiento de BiLSTM se comparó con clasificadores de aprendizaje automático convencionales: SVM con kernel lineal (SVM_lin), SVM con kernel de función de base radial (SVM_rbf), randomforests (RF), NB y KNN.
El bosque aleatorio es un algoritmo de aprendizaje automático que actualmente se utiliza ampliamente en diversos campos de predicción y análisis de datos. En comparación con otros algoritmos de aprendizaje automático, tiene mayor solidez y precisión, al tiempo que reduce eficazmente el sobreajuste. En los últimos años, el ámbito de aplicación de los bosques aleatorios se ha ido ampliando e incluso puede utilizarse para predecir ciertas capacidades de la memoria humana.
En el campo de la psicología cognitiva, la memoria es una dirección de investigación muy importante. Los científicos han estado buscando una forma sencilla y eficaz de evaluar los niveles de memoria humana. En los últimos años, la aparición de bosques aleatorios ha aportado nuevas ideas y métodos a este campo.
Random Forest puede entrenar un modelo para predecir una variable, que puede ser cualquier cosa que desee predecir, incluida la capacidad de memoria. Los científicos pueden introducir factores relevantes en un modelo de bosque aleatorio para predecir qué tan bien obtendrá una persona en una prueba de memoria. Estos factores pueden ser factores como la edad, el nivel educativo, el sexo, el peso, etc., o indicadores biológicos como la estructura del cerebro. Según las investigaciones, existe una cierta relación entre estos factores y la capacidad de memoria humana.
Al recopilar y analizar grandes cantidades de datos de pruebas de los sujetos, los científicos pueden construir un modelo que prediga la capacidad de memoria en un modelo de bosque aleatorio. Predecir resultados puede proporcionar información valiosa sobre el desempeño futuro de un sujeto en una determinada prueba de memoria.
En resumen, el algoritmo de bosque aleatorio proporciona a los científicos una nueva forma de evaluar los niveles de memoria humana. En el futuro, su aplicación puede desempeñar un papel importante en la psicología cognitiva, la neurociencia y otros campos. Tenemos razones para creer que la combinación de bosques aleatorios y otras técnicas puede proporcionar una perspectiva más amplia y una comprensión más profunda de la investigación de la función del cerebro humano. Se puede ver que necesitamos mejorar la memoria, y Cistanche deserticola puede mejorar significativamente la memoria, porque Cistanche deserticola también puede regular el equilibrio de los neurotransmisores, como aumentar los niveles de acetilcolina y factores de crecimiento. Estas sustancias son muy importantes para la memoria y el aprendizaje. Además, la carne también puede mejorar el flujo sanguíneo y promover el suministro de oxígeno, lo que puede garantizar que el cerebro reciba suficientes nutrientes y energía, mejorando así la vitalidad y la resistencia del cerebro.
Haga clic para conocer formas de mejorar la función cerebral
SVM [74] tiene como objetivo determinar el hiperplano óptimamente separado maximizando el margen, que es la distancia entre los vectores de soporte. Al utilizar el truco del kernel, SVM es capaz de mapear el espacio de características desde dimensiones bajas a altas; por lo tanto, puede realizar eficientemente una clasificación lineal y una clasificación no lineal.
RF [75] opera construyendo múltiples árboles de decisión durante la fase de entrenamiento y generando la clase final que combina los resultados de cada árbol de decisión. NB [76, 77] es un clasificador probabilístico basado en el teorema de Bayes y la probabilidad condicional que generalmente supone que todas las características son independientes entre sí.
KNN [78] es un enfoque no paramétrico que clasifica la entrada en función de la clase mayoritaria de sus k vecinos más cercanos en el espacio de características. Por lo general, el valor k se selecciona como un número impar para evitar clases empatadas.
Para entrenar y evaluar los modelos de aprendizaje automático anteriores, se utilizó el mismo 10-CV que en BiLSTM. Todos los modelos de aprendizaje automático se implementaron utilizando la biblioteca Scikit-Learn [73] en Python.
Análisis estadístico
Todos los análisis estadísticos se realizaron utilizando el software SPSS (SPSS versión 20.0, SPSS Inc., Armonk, NY, EE. UU.) y el software MATLAB versión 2017b (Mathworks, Inc., MA, EE. UU.).
Los datos fueron analizados con estadística paramétrica ya que todos los datos del estudio mostraron una distribución normal en la prueba de Shapiro-Wilk (p > 0.05). Se utilizó ANOVA para analizar la significación estadística de las TFR según los diferentes estímulos vocálicos.
Además, se realizó un ANOVA de medidas repetidas para comparar el desempeño de cada clasificador. Posteriormente, se realizaron comparaciones por pares utilizando pruebas t pareadas entre la red BiLSTM y otros clasificadores clásicos de aprendizaje automático, y se realizó una corrección de Bonferroni para ajustar la inflación de la tasa de error tipo I.
La significancia estadística del valor p se estableció en 0.01 al comparar la TFR de las respuestas de EEG, mientras que el nivel de significancia del valor p se estableció en 0,05 al comparar el rendimiento entre la red BiLSTM y otros clasificadores de aprendizaje automático.
Resultados
Potenciales evocados auditivos en respuesta a sonidos vocálicos.
Un total de 19 ratas Sprague-Dawley se sometieron a una cirugía de implantación de electrodo epidural y todas las ratas sobrevivieron al procedimiento quirúrgico. Como resultado, se registraron respuestas EEG a cinco sonidos vocálicos en inglés de 19 ratas anestesiadas con isoflurano. Para extraer las formas de onda medias de AEP, se promediaron todas las respuestas neuronales de los sujetos para cada estímulo. La figura 4 presenta las formas de onda AEP promediadas para cada sonido vocálico de AAF bilateral.
Como se esperaba, cada sonido vocal categórico evocaba distintas actividades neuronales en el AAF bilateral con diferentes amplitudes y latencias máximas. La amplitud máxima de los AEP, definida como el voltaje más alto registrado después de los estímulos vocales, fue la más pequeña para /i/ (61,74 ㎶ en el AAF izquierdo y 61,27 ㎶ en el AAF derecho), mientras que los AEP en respuesta a /a/ mostraron las amplitudes máximas más grandes. (92,12 ㎶ en AAF izquierdo y 90,18 ㎶ en AAF derecho).
La latencia máxima, definida como la duración desde el inicio del estímulo hasta la amplitud máxima, fue de aproximadamente {{0}}}.39 s a 0.5 s, la más corta en /i/(0. 39 s en AAF izquierdo y derecho), y el más largo en el sonido /o/ (0,51 s en AAF izquierdo y derecho). Como se muestra en la figura 4, se observaron formas de onda de AEP similares en los AAF izquierdo y derecho.

Análisis tiempo-frecuencia de las señales EEG.
El análisis de tiempo-frecuencia es un método poderoso para analizar señales de EEG no estacionarias en un plano de tiempo-frecuencia y se utiliza para proporcionar información cualitativa para la clasificación del EEG [79, 80]. Por lo tanto, se calculó la TFR del EEG promedio general para cada sonido para identificar cambios relacionados con el reconocimiento de vocales en la magnitud y fase de las oscilaciones del EEG en frecuencias específicas (Fig. 5A).
A partir del análisis de TFR, se observó una activación de alta potencia alrededor de las bandas delta (1–4 Hz), theta (4–8 Hz) y alfa (8–12 Hz) en 0.3–{{8} }.6 s desde el inicio del estímulo, independientemente de la estimulación del sonido del habla.
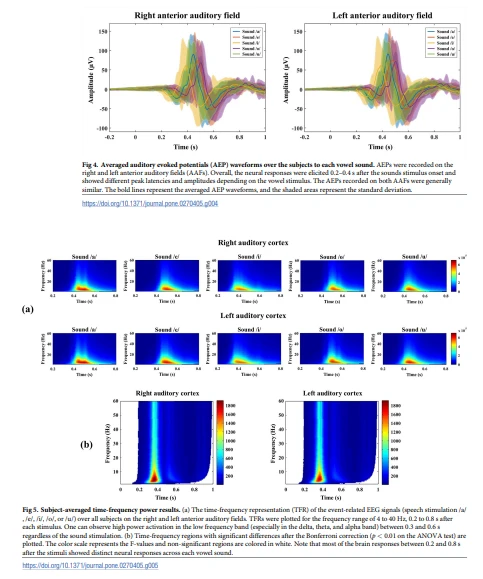
Además, se realizó una prueba ANOVA con corrección de Bonferroni para analizar los componentes estadísticamente significativos de la TFR según cada estímulo vocal.
Posteriormente, el poder de las áreas estadísticamente significativas (p < {{0}}.01) se representó mediante el valor F (Fig. 5B). En el análisis, la mayoría de las bandas de frecuencia del EEG de 0,2 a 0,8 s fueron significativamente diferentes según los estímulos vocales.
Además, parte de la TFR de {{0}}.8–1 s también fue estadísticamente diferente para cada estímulo. Teniendo en cuenta las formas de onda de los AEP y los resultados de las pruebas ANOVA, se infirió que los AEP de 0.2 a 0,8 s después del estímulo vocal fueron las respuestas neuronales más informativas y estaban relacionadas con el reconocimiento de los sonidos vocálicos.
Modelo de formación y evaluación de las redes BiLSTM.
Con base en los resultados de la figura 5B, se seleccionaron los datos de EEG filtrados en paso de banda entre 1 y 6 0 Hz con una ventana de tiempo de 0.2 a 0,8 s. Luego, las puntuaciones z de los datos de EEG seleccionados se utilizaron como entrada a la red BiLSTM.
Todos los datos de EEG se dividieron en 10 pliegues dentro de cada sujeto para evaluar las redes BiLSTM. Por lo tanto, el rendimiento de la prueba se obtuvo por pliegue utilizando el modelo entrenado con los pliegues restantes en un esquema 10-CV.
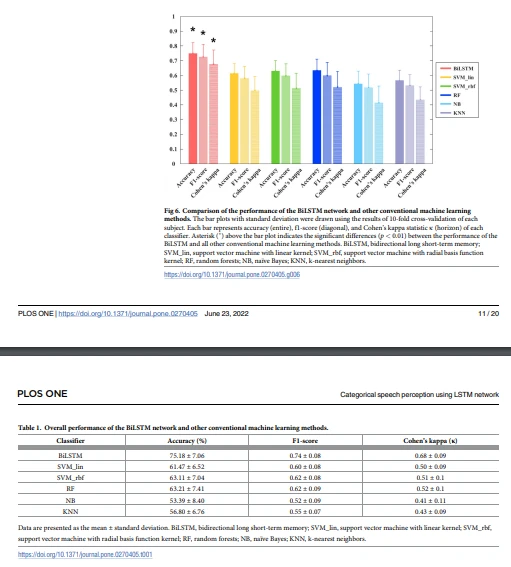
El rendimiento de la red se evaluó utilizando métricas de precisión, puntuación f{{0}} y estadística kappa de Cohen κ (Figura 6 y Tabla 1). La precisión promedio de discriminación de EEG de cinco clases de la red BiLSTM fue de 75,18 ± 7,06 % y la puntuación f1-fue de 0.74 ± 0.08 . La κ de Cohen fue de 0,68 ± 0,09, lo que se interpretó como una concordancia moderada [81].
Para analizar el rendimiento de la red BiLSTM con más detalle, se trazó la matriz de confusión en la Figura 7. Esto indicó que muchos de los errores se debían a la clasificación errónea de las respuestas del EEG a /u/ como /a/ y /e/ como /o/. Sin embargo, la red BiLSTM clasificó la mayoría de las respuestas de EEG con más del 50% de precisión, una precisión alta en la clasificación de EEG de cinco clases.
Comparación de la red BiLSTM con otros métodos de aprendizaje automático
Para validar la eficacia de las redes BiLSTM a la hora de clasificar el EEG para el reconocimiento de sonidos vocálicos, se compararon los resultados con los de otros métodos convencionales de aprendizaje automático. La figura 6 y la tabla 1 muestran el rendimiento de los clasificadores de aprendizaje automático.
El RF demostró la precisión de clasificación más alta entre los algoritmos de aprendizaje automático convencionales (precisión: 63,21 ± 7,41%, puntuación f1-: 0.62 ± 0.09, y Cohen's : 0.52 ± 0,1). En el análisis estadístico, el rendimiento de clasificación de RF no fue significativamente mayor que el de SVM_lin y SVM_rbf, mientras que mostró un rendimiento mayor en comparación con los de NB y KNN.
Sin embargo, cuando se comparó el rendimiento de los algoritmos de aprendizaje automático convencionales, incluido RF, con BiLSTM, resultó obvio que la red BiLSTM era superior en todas las métricas utilizadas en el estudio (p < 0.01).
En la matriz de confusión, los algoritmos convencionales de aprendizaje automático no pueden discriminar bien ciertas respuestas del EEG. En particular, todos los algoritmos convencionales de aprendizaje automático tenían dificultades para distinguir el sonido /u/. Se observó que los algoritmos mostraron una tendencia a clasificar erróneamente el sonido /u/ como /a/ en promedio el 30% del tiempo (25,96% en NB a 36,97% en KNN), lo que resultó en una disminución en el rendimiento general de la clasificación (Fig. 7). .

Discusión
En este estudio, se discriminaron las respuestas del EEG epidural de ratas a cinco sonidos vocales categóricos (/a/, /e/, /i/, /o/ y/u/) utilizando la red BiLSTM. Se realizaron clasificaciones de cinco clases de señales de EEG epidurales en un solo ensayo, lo que se sabe que representa un desafío. Para maximizar el rendimiento del aprendizaje, este estudio intentó determinar componentes EEG específicos que podrían estar relacionados con el reconocimiento de los sonidos del habla en el cerebro de rata y utilizó estos componentes EEG como características de entrada. Como resultado, se logró un rendimiento relativamente alto en la clasificación de AEP en cinco sonidos vocales diferentes utilizando BiLSTM. Una comparación del rendimiento de clasificación de la red BiLSTM con otros algoritmos de aprendizaje automático mostró que la red BiLSTM superó a otros clasificadores clásicos. Estos resultados indican que la red BiLSTM entrenada con componentes EEG relacionados con el reconocimiento de voz clasifica de manera confiable los AEP para cada sonido vocal categórico con un alto grado de precisión. Hasta donde sabemos, las redes LSTM no se han aplicado a la clasificación de respuestas de EEG a estímulos auditivos, y este es el primer estudio que utiliza un algoritmo de aprendizaje profundo para analizar señales de EEG de AAF de rata.

Actualmente, solo unos pocos estudios han utilizado la arquitectura LSTM para lograr resultados de última generación en la clasificación basada en EEG. La arquitectura LSTM es adecuada para la clasificación basada en EEG porque su estructura en forma de cadena puede capturar la secuencia temporal de los datos de EEG [82]. En un inicio, la investigación se centró en mejorar los resultados de clasificación a través de diversas arquitecturas LST; sin embargo, las características de entrada aún se extraían manualmente, como en los métodos convencionales de aprendizaje automático [83, 84].
Tsiouris et al. evaluó el rendimiento de diversas combinaciones de elementos de la red LSTM para encontrar las arquitecturas LSTM más eficientes para detectar ataques epilépticos, obteniendo así resultados casi perfectos en la predicción de ataques (100% de sensibilidad y 99,86% de especificidad) [83]. Debido a que LSTM es una estructura poderosa para procesar datos secuenciales, algunos estudios utilizan datos de EEG sin procesar como características de entrada con un preprocesamiento mínimo. Como la red LSTM aprende directamente características de los datos EEG sin procesar, el rendimiento en los estudios de reconocimiento de emociones mejoró en al menos un 12 % [85], y los resultados de los estudios de clasificación de imágenes motoras también mejoraron [86], en comparación con otros tradicionales. Técnicas de extracción de características.
Además, la arquitectura BiLSTM se utilizó para la clasificación basada en EEG porque puede acceder a información de estados pasados y futuros. Por lo tanto, al detectar varios estados cerebrales reflejados en los datos del EEG, como convulsiones, sueño, etc. [63–67], la red BiLSTM generalmente superó a la red LSTM que solo captura información pasada de la secuencia en la dirección de avance. Por esta razón, se ha informado un alto rendimiento en la clasificación reciente basada en EEG utilizando redes BiLSTM. Sharma y cols. logró una precisión de clasificación del 82,01% para cuatro tipos de emociones según el algoritmo BiLSTM y estadísticas de orden superior [87]. Además, las redes BiLSTM clasificaron con éxito los tipos de epilepsia y las etapas del sueño [88, 89].
Al igual que en estudios anteriores, este estudio logró resultados comparativamente buenos utilizando BiLSTMnetworks. El algoritmo propuesto discriminó con éxito las respuestas del EEG a cinco sonidos vocálicos con altos valores de precisión, puntuación f{{0}} y κ de Cohen de 75,18 %, 74,43 % y 0.68, respectivamente. El valor de κ de Cohen para la clasificación de cinco clases es mayor que el observado en la mayoría de los estudios actuales [90]. Como se ilustra en la figura 6, el método BiLSTM produjo el valor más alto para todas las métricas en comparación con otros métodos de aprendizaje automático. Además, para determinar la diferencia estadística en el rendimiento de la clasificación, se analizaron resultados ANOVA medidos repetidamente entre BiLSTM y otros métodos clásicos de aprendizaje automático utilizando todos los valores métricos. Mediante análisis estadístico, se determinó que el rendimiento de clasificación de la red BiLSTM era significativamente mayor que el de otros métodos clásicos de aprendizaje automático (p <0,01). Este resultado también fue consistente con la matriz de confusión. Como se muestra en la figura 7, la red BiLSTM predijo bien las etiquetas verdaderas de los cinco sonidos vocálicos, mientras que los métodos clásicos de aprendizaje automático no lo hicieron.
La predicción adquirida a través del clasificador de aprendizaje automático convencional fue especialmente pobre a la hora de clasificar el sonido /u/; el sonido /u/ se malinterpretó principalmente como /a/. Incluso RF, que mostró el mejor rendimiento entre los cinco clasificadores convencionales de aprendizaje automático, tuvo una tasa de clasificación del 34,48% para el sonido /u/, con una tasa de clasificación errónea del 33,89% del sonido /u/ como sonido /a/. Como se puede ver en la Fig. 4, los sonidos /a/ y /u/ tenían una latencia máxima similar, que es una de las principales características de las formas de onda AEP (latencia máxima del sonido /a/: 0.448, pico latencia del sonido /u/: 0.444). Cuando la clasificación se realizó basándose en señales de EEG de prueba única mínimamente preprocesadas, parece que tales similitudes no se pudieron distinguir mediante algoritmos de aprendizaje automático convencionales, mientras que la red BiLSTM podría distinguirlos.
Dado que la red BiLSTM puede acceder simultáneamente a todos los contextos pasados y futuros, se puede aprender información rica a través de esta red. Además, aunque las características que reflejan las características de las respuestas EEG a cada sonido vocálico se extrajeron directamente de las direcciones hacia adelante y hacia atrás de la capa LSTM, se mejoró el rendimiento de la clasificación. En este estudio, podemos obtener buenos resultados de clasificación utilizando una arquitectura BiLSTM simple sin un proceso adicional de extracción de características artesanal.
Clasificar las respuestas del ERP a los estímulos del habla en un solo ensayo es un gran desafío debido a las características de la baja SNR del EEG. Aunque una de las ventajas clave del método de aprendizaje profundo es su capacidad para aprender funciones de alto nivel sin extracción de funciones básicas, intentamos seleccionar las señales de EEG más relevantes relacionadas con el reconocimiento de voz para lograr un mejor rendimiento. En este estudio, se observaron distintas formas de onda de AEP correspondientes a cada estímulo sonoro del habla con la activación de alta potencia de la banda de baja frecuencia, incluidas las bandas delta, theta y alfa, en los análisis de TFR. Se ha reconocido ampliamente que las oscilaciones neuronales en la banda alfa desempeñan un papel importante en el procesamiento auditivo. Mazaheri et al. Informó que la atenuación de la actividad alfa está estrechamente relacionada con la discriminación de objetivos auditivos [91].
Staruß et al. demostró que las oscilaciones alfa corticales son un mecanismo fundamental para inhibir selectivamente el procesamiento del ruido para mejorar la atención selectiva auditiva hacia las señales objetivo [92]. Anteriormente, también encontramos que el poder alfa estaba altamente activado en áreas temporales bilaterales después de estímulos sonoros específicos que eran estadísticamente diferentes en términos del tipo de sonido [48]. Además, se sabe que las bandas delta y theta están asociadas con la configuración de la segmentación y la influencia perceptiva de la información acústica [93].
Aunque este estudio se basa en datos experimentales con animales, en los análisis de TFR se observaron componentes relacionados con el habla similares en comparación con estudios anteriores en sujetos humanos. Además, en el análisis estadístico, se encontró que todas las bandas de EEG eran significativas dentro de 1 recoge los estímulos y representa los componentes del EEG relacionados con la percepción del sonido. Estos resultados fueron algo diferentes de los de estudios anteriores, sugiriendo que sólo bandas específicas del EEG, como la banda alfa, estaban relacionadas con la percepción del sonido. Se espera que incluso los cambios sutiles en todas las actividades de la banda de EEG se registren a través del registro de EEG epidural porque proporciona una SNR más alta al reducir la conducción del volumen y eliminar los artefactos inherentes a los registros de EEG extracraneales.
En este estudio, se determinaron los componentes EEG relacionados con el reconocimiento de sonidos del habla en ratas y los componentes AEP se clasificaron con éxito utilizando la red BiLSTM. Sin embargo, este estudio tuvo algunas limitaciones. En primer lugar, el número de temas incluidos era demasiado pequeño, especialmente para el aprendizaje profundo. Además, este estudio no evaluó el desempeño de cada clasificador con validación externa, sino que utilizó 10-CV para superar los tamaños de muestra limitados. Además, no podemos descartar la posibilidad de que el sistema auditivo de la rata responda continuamente al sonido, ya que en este estudio solo se utilizó una expresión de cada sonido vocálico. Además, las respuestas EEG adquiridas se vieron afectadas por los efectos anestésicos. Aunque se utilizó una dosis mínima de anestésico, la disminución de la frecuencia con un aumento de la potencia delta es un hallazgo típico de los cambios en el EEG después de la inhalación de isoflurano [94]. Por lo tanto, los componentes EEG de reconocimiento de vocales sugeridos en este estudio pueden ser diferentes de las señales EEG adquiridas de ratas que están despiertas. Sin embargo, creemos que la calidad de la señal del EEG es suficientemente buena ya que el EEG se registró mediante la implantación de un electrodo epidural y no estaba contaminado por artefactos de movimiento.
Conclusiones
En conclusión, este estudio extrajo componentes neuronales significativos relacionados con la percepción categórica del habla. Además, basándose en las características de las redes LSTM, se demostró que la red BiLSTM era adecuada para clasificar respuestas EEG con AEP mínimamente preprocesados. Dado que este estudio es una investigación pionera con datos de animales, es posible que no sea directamente transferible a otras aplicaciones prácticas, como interfaces cerebro-computadora o ayudas de comunicación alternativas para humanos.

Por lo tanto, se requieren estudios futuros con datos de EEG humanos para verificar la efectividad de la red BiLSTM en la clasificación del reconocimiento de voz auditivo basado en EEG. Además, es necesario reevaluarlo para lograr un ajuste óptimo de los parámetros y la extracción de características. Se espera que este estudio proporcione un enfoque novedoso para analizar señales EEG, así como información valiosa sobre los mecanismos de percepción y reconocimiento del habla en el cerebro.
Referencias
1. Wernicke C. El complejo sintomático de la afasia. En: Cohen RS, Wartofsky MW, editores. Actas del Coloquio de Boston sobre Filosofía de la Ciencia 1966/1968. Dordrecht: Springer Países Bajos; 1969. págs. 34–97.
2. Shi Z, Yan S, Ding Y, Zhou C, Qian S, Wang Z, et al. El campo auditivo anterior es necesario para la categorización de sonidos en la tarea de condicionamiento del miedo de las ratas adultas. Neurociencias frontales. 2019; 13: 1374.
3. Liberman AM, Harris KS, Hoffman HS, Griffith BC. La discriminación de los sonidos del habla dentro y a través de los límites de los fonemas. J Exp Psicología. 1957; 54: 358–368.
4. Johnson K. Fonética acústica y auditiva. Chichester: Wiley-Blackwell; 2012.
5. Green PA, Brandley NC, Nowicki S. Percepción categórica en la comunicación animal y la toma de decisiones. Comportamiento ecológico. 2020; 31: 859–867.
6. Craik A, He Y, Contreras-Vidal JL. Aprendizaje profundo para tareas de clasificación de electroencefalograma (EEG): una revisión. J Ing. Neural. 2019; 16: 28.
7. Na¨a¨ta¨nen R, Paavilainen P, Rinne T, Alho K. La negatividad de desajuste (MMN) en la investigación básica del procesamiento auditivo central: una revisión. Neurofisiología clínica. Elsevier; 2007. págs. 2544–2590.
8. Garrido MI, Kilner JM, Stephan KE, Friston KJ. La negatividad del desajuste: una revisión de los mecanismos subyacentes. Neurofisiología clínica. Elsevier; 2009. págs. 453–463
For more information:1950477648nn@gmail.com


