Un algoritmo genético basado en conjuntos de dos pasos para la clasificación de la cobertura terrestre
Oct 20, 2023
Abstracto—Los mapas precisos de uso y cobertura del suelo (LULC) son herramientas eficaces para ayudar a lograr una planificación urbana sólida y una agricultura de precisión. Como tecnología de optimización inteligente, el algoritmo genético (GA) se ha aplicado con éxito a diversas tareas de clasificación de imágenes en los últimos años. Sin embargo, los AG simples enfrentan desafíos, como cálculos complejos, baja inmunidad al ruido y una convergencia lenta. Esta investigación propone un protocolo conjunto de dos pasos para la clasificación LULC utilizando un modelo GA basado en escala de grises. El primer marco de conjunto utiliza c-means difusos para clasificar los píxeles en aquellos que son difíciles de agrupar y aquellos que son fáciles de agrupar, lo que ayuda a reducir el espacio de búsqueda para el cálculo evolutivo. El segundo marco de conjunto utiliza ventanas de vecindad como información heurística para modificar de forma adaptativa la función objetivo y la probabilidad de mutación de GA, lo que aporta valiosos beneficios a la discriminación y decisión de GA. En este estudio, se utilizan tres áreas de investigación en Dangyang, China, para validar la eficacia del método propuesto. Los experimentos muestran que el método propuesto puede mantener eficazmente los detalles de la imagen, restringir el ruido y lograr una rápida convergencia de algoritmos. En comparación con los métodos de referencia, la mejor precisión general obtenida por el algoritmo propuesto es del 88,72%. Términos del índice: algoritmo genético (GA), uso y cobertura del suelo (LULC), ventana de vecindario, clasificación de imágenes de teledetección, conjunto de dos pasos.

cistanche tubulosa-mejora el sistema inmunológico
I. INTRODUCCIÓN
El uso y la cobertura del suelo (LULC) desempeñan un papel esencial en diversos aspectos, incluidos los ecosistemas y la planificación urbana. Manuscrito recibido el 18 de abril de 2022; revisado el 2 de septiembre de 2022; aceptado el 16 de noviembre de 2022. Fecha de publicación 30 de noviembre de 2022; fecha de la versión actual 15 de diciembre de 2022. Este trabajo fue apoyado en parte por la Fundación Nacional de Ciencias Naturales de China bajo la subvención 62201438, subvención 61772397 y subvención 12005159, en parte por la clave especial de innovación en ciencia y tecnología forestal de Shaanxi bajo la subvención SXLK{{ 13}}, en parte por el Programa de Investigación Básica de Ciencias Naturales de Shaanxi bajo la Subvención 2021JC-23, y en parte por el Proyecto de Desarrollo y Tecnología Científica de la Oficina de Ciencia y Tecnología de Yulin bajo la Subvención CXY-2020-094. (Yang Cao y Wei Feng contribuyeron igualmente a este trabajo). (Autores correspondientes: Wei Feng; y Yinghui Quan.) Yang Cao, Wei Feng, Yinghui Quan, Yijia Song y Aifeng Ren trabajan en el Departamento de Ciencia y Tecnología de Teledetección. , Escuela de Ingeniería Electrónica, Universidad de Xidian, Xi'an 710071, China (correo electrónico: ycao6@stu.xidian.edu.cn; wfeng@xidian.edu.cn; yhquan@mail.xidian.edu.cn; yijia_son@ 163.com; afren@mail.xidian.edu.cn). Wenxing Bao trabaja en la Facultad de Ingeniería y Ciencias de la Computación de la Universidad North Minzu, Yinchuan 750021, China (correo electrónico: baowenxing@nun.edu.cn). Gabriel Dauphin trabaja en el Laboratorio de Procesamiento y Transmisión de Información, Institut Galilée, Universidad París XIII, 93430 Villetaneuse, Francia (correo electrónico: gabriel.dauphin@univ-paris13.fr). Mengdao Xing trabaja en la Academia de Investigación Interdisciplinaria Avanzada, Universidad de Xidian, Xi'an 710071, China (correo electrónico: xmd@xidian.edu.cn). Identificador de Objeto Digital 10.1109/JSTARS.2022.3225665 y economía social, de profunda importancia en el sistema Tierra [1], [2], [3], [4]. Los estudios de campo, que dependen de la interpretación manual, requieren mucho tiempo y trabajo y no pueden clasificar el estado del uso de la tierra en el tiempo [5], [6], [7]. Por el contrario, los avances recientes en la tecnología satelital ofrecen un excelente potencial para distinguir con precisión entre diversas características terrestres y crear rápidamente mapas LULC de la vasta área [8], [9], [10]. La clasificación de imágenes de teledetección se divide a grandes rasgos en enfoques supervisados y no supervisados [11], [12], [13], [14]. El rendimiento superior de los clasificadores supervisados depende sustancialmente de los datos etiquetados de alto costo, que son difíciles de obtener [15]. Los clasificadores no supervisados obtienen una distribución de datos dividiendo la imagen en grupos de píxeles con características similares, como K-medias [16], ISODATA [17] y c-medias difusas (FCM) [18], que se han utilizado con éxito en la Dominio de clasificación LULC. Por ejemplo, Dang et al. [19] propusieron la agrupación de FCM colaborativos de múltiples núcleos con una técnica de granulación de superpíxeles ponderada, que puede reducir los objetos considerados de clasificación de cobertura terrestre de una gran cantidad de píxeles a solo unos pocos cientos de superpíxeles de los objetos considerados. Paradis relajó el supuesto de varianza homogénea en el algoritmo estándar k-means y presentó un nuevo método de clasificación de cobertura terrestre llamado k-means probabilístico (P-Kmeans) [20]. Este método funciona bien con datos multiespectrales de ruido y tiene una mejora sustancial en la precisión general (OA) en comparación con las k-medias simples. Desafortunadamente, las predicciones de estos clasificadores solo consideran características espectrales e ignoran su correlación espacial, lo que genera una robustez deficiente. Se ha descubierto que la representación conjunta de características espaciales-espectrales mejora la inmunidad al ruido del algoritmo y reduce los errores de clasificación en muchos modelos de clasificación existentes [21], especialmente en los algoritmos de agrupamiento difuso [22], [23], [24]. FLICM [25] utiliza mediciones de similitud en escala de grises y espacio difuso para mejorar la retención de detalles de la imagen al tiempo que garantiza la insensibilidad al ruido. Zhang et al. [26] mejoraron el algoritmo FCM convencional utilizando factores de ponderación adaptativos para efectos de píxeles vecinos basándose en un novedoso modelo de atracción espacial de píxeles. Lei et al. [27] propusieron un FRFCM más simple y significativamente más rápido mediante la introducción de operaciones de reconstrucción morfológica y filtrado de membresía local. Wang y cols. [28] presentaron FCM_SICM con restricción de intensidad espacial adaptativa y vinculación de membresía, reduciendo la complejidad temporal de la función objetivo de O (n4). Sin embargo, los algoritmos FCM mejorados todavía presentan desafíos en términos de reducción de interferencias de ruido.

Beneficios de la cistanche tubulosa-fortalecer el sistema inmunológico
Se ha demostrado que el problema de clasificación de la tierra se puede descomponer en múltiples tareas de clasificación binaria [29]. Por lo tanto, encontrar una clasificación óptima se considera un problema de optimización combinatoria. Durante la última década, ha habido un avance notable en la investigación de la clasificación del uso de la tierra basada en el cálculo evolutivo [30], [31]. Por ejemplo, Yang et al. presentó una técnica basada en la optimización de enjambre de partículas (PSO) y diseñó una función de criterio para identificar la cobertura del suelo [32]. Sarkar et al. [33] utilizaron la entropía máxima de Rènyi (MRE) para desarrollar un enfoque para la clasificación no supervisada de la cobertura terrestre basada en la evolución diferencial (DE), que funciona bien en dos datos de imágenes hiperespectrales ampliamente utilizados. Los algoritmos genéticos (GA), algoritmos de optimización global eficaces, imitan mecanismos genéticos biológicos en el proceso de selección natural para determinar una solución global óptima [34], [35], [36], [37]. El GA estándar requiere una operación de codificación binaria para representar una solución candidata en forma de cadena [38], [39], [40]. En cada iteración, el operador cruzado selecciona aleatoriamente dos soluciones candidatas (es decir, padres) e intercambia parte de su información para crear nuevas soluciones (es decir, descendencia), lo que mejora la capacidad de exploración de la población [41]. Al igual que la mutación genética en la naturaleza, el operador de mutación se aplica al GA para cambiar parte de la información en las soluciones de la descendencia y mejorar la capacidad de búsqueda local [42]. El operador de selección selecciona las soluciones candidatas en función de la idoneidad de cada miembro de la población, reservando mejores progenies y eliminando progenies malas. Este mecanismo, a su vez, mejora el equilibrio entre explotación y exploración [43]. Mediante los operadores genéticos mencionados anteriormente, estos individuos se combinan para producir una nueva generación de grupos de solución candidatos, y el proceso se repite hasta que se satisface algún índice de convergencia. GA adquiere y acumula conocimiento sobre la dirección de búsqueda durante el proceso de búsqueda y, por lo tanto, controla automáticamente la dirección de búsqueda para generar la solución óptima [44], que se ha aplicado con éxito a la clasificación de imágenes de teledetección y ha logrado buenos resultados. En los últimos años han surgido muchos AG mejorados [45]. Sin embargo, todavía quedan cuestiones sin resolver. 1) Cálculos extensos. La convergencia de GA se deteriora cuando el conjunto de datos aumenta. 2) El pobre rendimiento antiruido del GA simple que se centra en características espectrales suele ser sensible a los ruidos en la imagen. 3) Convergencia prematura. GA tiene una capacidad de búsqueda limitada para el nuevo espacio y es propenso a caer en el óptimo local. Como los datos de teledetección se caracterizan por la heterogeneidad, nos centramos en clasificadores de conjuntos, que enfatizan la complementariedad entre las diversas características de clasificación [46], [47], [48]. La idea fundamental de la estrategia de conjunto es mezclar y combinar predicciones de diferentes reglas de clasificación [49], [50]. En el estudio de [51], se propone un modelo de clasificación de conjuntos de alta precisión para proporcionar múltiples mapas de clasificación independientes mediante diferentes descriptores de características. El estudio de [52] indica que el marco conjunto que consta de un mecanismo de votación de dos pasos puede suprimir el ruido de los datos de la imagen original y refinar la clasificación del hielo marino hasta cierto punto.

Beneficios del suplemento cistanche: aumentar la inmunidad.
Haga clic aquí para ver los productos Cistanche Enhance Immunity
【Pregunte por más】 Correo electrónico:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
En este artículo, se propone un modelo GA mejorado basado en estrategias de conjunto de dos pasos (TE-nGA) para la clasificación de cobertura terrestre de imágenes multiespectrales. Para las deficiencias de GA, nuestra solución es utilizar una estrategia de conjunto y ventanas espaciales además de un GA clásico para mejorar el rendimiento antiruido, la precisión de la clasificación y la velocidad de convergencia. Las principales contribuciones de este artículo son las siguientes. 1) El algoritmo FCM se utiliza para clasificar los píxeles en aquellos que son difíciles de agrupar y aquellos que son fáciles de agrupar, lo que reduce la complejidad computacional. 2) Se propone un AG basado en escala de grises considerando la ventana de vecindad espacial en la creación de parámetros heurísticos para evitar la convergencia prematura y la sensibilidad al ruido. 3) Se utiliza un novedoso marco de conjunto de dos pasos con un mecanismo de clasificación multibanda para reducir la inestabilidad de la solución y los errores de clasificación.
II. MÉTODO DE CLASIFICACIÓN PROPUESTO
El diagrama de flujo del algoritmo propuesto se muestra en la Fig. 1. Y el algoritmo consta principalmente de los siguientes tres pasos: eliminación de ruido de la imagen, encontrar los píxeles difíciles de agrupar mediante la estrategia de votación y reclasificación mediante GA mejorado basado en el modelo de conjunto y espectral-espacial. fusión. Tenga en cuenta que el segundo y tercer paso son las partes críticas del algoritmo propuesto. El método propuesto se describe en el Algoritmo 1.
A. Eliminación de ruido de imagen
Para evitar artefactos de imagen debido al ruido del sensor de imagen que afecta la calidad de la escena, el algoritmo consiste en aplicar primero la coincidencia de bloques y el filtrado 3-D, un algoritmo de eliminación de ruido eficaz y popular existente [53]. Las características de este filtrado se eligen en base a esta información general, es un equilibrio entre reducir el ruido restante en la imagen rectificada y preservar los cambios de intensidad entre los píxeles vecinos pertenecientes a diferentes grupos. Se ha demostrado que el algoritmo supera a otros algoritmos de filtrado a la hora de mejorar la calidad de la imagen.
B. Primera etapa de conjunto: encontrar píxeles difíciles de agrupar
El diagrama de bloques a la izquierda de la Fig. 1 muestra una imagen multiespectral con longitudes de onda D, de la cual se pueden extraer imágenes específicas de D con el tamaño H × W, denotadas como I1, I2,..., ID. El primer paso divide los píxeles entre los que son difíciles de agrupar y los que son fáciles de agrupar, de modo que al menos para una imagen espectral, su pertenencia es muy probable. Por lo tanto, la agrupación de FCM se aplica por separado en cada imagen espectral para clasificar los píxeles en N categorías, donde N se establece de antemano mediante una interpretación visual. Produce para cada píxel, cada longitud de onda y cada miembro del grupo.
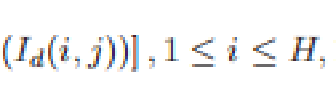

Fig. 1. Diagrama de flujo de clasificación LULC basado en el método propuesto.
donde Id(i, j) es la intensidad del píxel (i, j) en la d-ésima longitud de onda, un d (i, j) es la pertenencia al enésimo grupo del píxel (i, j) en la d-ésima longitud de onda, 1 Menor o igual a d Menor o igual a D, 1 Menor o igual a n Menor o igual a N. Para la longitud de onda d-ésima, cada píxel está marcado con una etiqueta de categoría cd(i, j), como

Según la membresía, los píxeles se clasifican como Ke fácilmente agrupables y Kd difíciles de agrupar. El umbral τ utilizado es un parámetro para garantizar que el píxel (i, j) ∈ Ke considerado fácil de agrupar tenga un alto grado de pertenencia al centro del clúster correspondiente. El grupo (N + 1) contiene los píxeles que se consideran difíciles de agrupar y se denota como Kd. Los enfoques basados en la votación pueden resolver conflictos entre diferentes decisiones generadas por múltiples reglas de clasificación. En consecuencia, los resultados de clasificación de cada longitud de onda obtenidos por FCM se integran en el mapa de clasificación de conjunto C, según el principio de votación por mayoría. La etiqueta de píxel en C se reasigna a la posición correspondiente de la imagen multiespectral filtrada y se obtienen los mapas de reclasificación finales, indicados como I1, I2,. . ., ID, como el cuadro que se muestra en el medio de la Fig. 1. Después de aplicar el algoritmo FCM para reclasificar los píxeles como fáciles y difíciles de agrupar, la cuestión de analizar la imagen original completa se convierte, por lo tanto, en la clasificación de los píxeles. píxeles difíciles.
C. Segunda etapa de conjunto-MejoradoGA teniendo en cuenta los píxeles vecinos
A la derecha del diagrama de flujo, un cuadro titulado "El conjunto de la segunda ronda" muestra dos tareas: clasificación GA basada en el factor conjunto espectral-espacio y conjunto de decisión para clasificación multibanda. Dado que el problema de clasificación LULC se descompone en múltiples tareas de clasificación binaria, debemos abordar subproblemas en serie para cada longitud de onda: si el píxel (i, j) ∈ Kd pertenece a la xésima categoría. 1 Menor o igual a x Menor o igual a N. Finalmente, los resultados de la decisión de todos los N mapas de clasificación binaria se combinan para obtener un mapa de clasificación que contiene N tipos de cobertura terrestre. Para cada problema de clasificación binaria, el GA mejorado basado en el espacio espectral se aplica a los píxeles marcados como la (N + 1)ésima clase para optimizar aún más las etiquetas de categorías ambiguas, ilustradas en el marco discontinuo de la Fig. 1. La interpretación de este GA mejorado basado en el espacio espectral es la siguiente. 1) Codificación de cromosomas binarios bidimensionales: para la identificación de imágenes, se pueden extraer N mapas binarios de N tareas de clasificación. La codificación binaria bidimensional se utiliza para mantener las propiedades estructurales espaciales de los individuos evolucionados (un individuo representa una decisión potencial). El tamaño de la matriz de codificación es el mismo que el de la imagen de longitud de onda, es decir, H × W. Para estimar si el píxel (i, j) ∈ Kd pertenece a la categoría x, 1 Menor o igual a x Menor o igual a N, para Para cada longitud de onda, codificamos los píxeles (i, j) ∈ Ke en la clase x agrupados por el FCM como 1 y sin categoría x como 0, donde no se realiza ninguna operación de optimización de la evolución. Esos puntos (i, j) ∈ Kd se codifican aleatoriamente como 0 o 1. La optimización evolutiva implementada en Kd explorará todas las soluciones posibles. 2) Función de aptitud basada en la ventana de vecindario: La función de aptitud es el indicador más crítico para evaluar la calidad de los individuos de una población, el cual está relacionado con la selección de individuos y la ejecución de operadores genéticos. Los píxeles adyacentes están altamente correlacionados en términos de escala de grises y textura. En consecuencia, se adopta la información complementaria de los espectros y el espacio para desarrollar una función de aptitud compuesta, que proporciona una idea novedosa para mejorar la inmunidad al ruido del algoritmo. Para la enésima tarea de agrupamiento en la d-ésima longitud de onda, supongamos que el número de individuos en la población es P, CIp,n,d es la ruta de los individuos, 1 Menor o igual a p Menor o igual a P, 1 Menor o igual a n Menor o igual a N, 1 Menor o igual a d Menor o igual a D. La función de aptitud de CIp,n,d es Aptitud=1 OF, OF se calcula mediante la fórmula (3)

donde r ∈ {{{0}}, 1}, Rr indica los píxeles codificados como 0 o 1, y sus estadísticas de cantidad se representan como Nr. El centro del grupo r vr se calcula mediante la media de píxeles de todos los puntos que pertenecen a Rr. I d(i, j) es la intensidad del píxel (i, j) en la longitud de onda d-ésima después de aplicar el algoritmo de agrupamiento FCM. En la función de vecindad Wr(i, j), se supone que las ventanas de vecindad son cuadradas y que las longitudes de sus lados s son números enteros impares. N (i, j, s) representa la ventana de vecindad s × s en la ubicación indexada (i, j). Nt(i, j, s) representa la intensidad del tésimo píxel en la vecindad N(i, j, s). El grado de membresía del t-ésimo píxel en N(i, j, s) que pertenece al r-ésimo grupo se denota como utr(i, j, s). lt (i, j, s) representa la distancia espacial entre el enésimo píxel vecino y el punto central (i, j). L es el peso de la distancia espacial entre el punto central y sus píxeles vecinos. 3) Operador de mutación que utiliza información del vecindario: las nuevas generaciones se generan de forma iterativa mediante selección individual, cruce uniforme y mutación genética, como se ilustra en el marco discontinuo de la Fig. 1. La mayoría de los AG utilizan una probabilidad de mutación global para implementar la modificación de la etiqueta de forma aleatoria. píxeles seleccionados con la misma probabilidad, lo que ralentiza de forma invisible la tasa de convergencia de GA. Como operador técnico crítico, se crea una probabilidad de mutación heurística mejorada, en combinación con información de vecindad, para calcular automáticamente la probabilidad de mutación apropiada para cada gen. Las siguientes fórmulas definen esta nueva probabilidad de mutación:
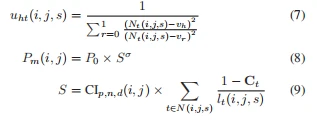
para el píxel central (i, j), uht(i, j, s) denota el grado de pertenencia del punto vecino Nt(i, j, s) que pertenece al centro de agrupamiento vh, h ∈ {{{0} }, 1}. En consecuencia, la probabilidad de mutación adaptativa Pm(i, j) del CIp,n,d individual se expresa como la fórmula 8, donde P0 es la probabilidad de mutación básica, también la probabilidad de mutación global en GA clásico; σ, el exponente de S, representa el peso de la influencia de la información de la vecindad sobre la probabilidad de mutación del píxel central. CIp,n,d(i, j) es la codificación binaria de la ruta individual, para la enésima tarea de agrupamiento en la désima longitud de onda. lt(i, j, s) indica la distancia espacial entre el píxel central (i, j) y el píxel t en N (i, j, s). La etiqueta de Nt(i, j, s) se denota como Ct, si u1t es mayor que u0t, entonces Ct=1; de lo contrario, Ct=0. Considerando las diferentes ventanas de vecindad, cuando s=3, se puede calcular que S ∈ [0, 4+2√2]; cuando s=5, S ∈ [0, 6+3√2+1.6 √5]. A través del mecanismo mencionado anteriormente, los puntos (i, j) ∈ Kd pueden adquirir de forma adaptativa probabilidades de mutación apropiadas en función de la categoría de los píxeles vecinos. Cuando la etiqueta estimada CIp,n,d(i, j) concuerda con la mayoría de las categorías de píxeles circundantes, se requiere una pequeña probabilidad de mutación para mantener la homogeneidad regional original. De lo contrario, la probabilidad de mutación aumenta para hacer que CIp,n,d(i, j) tienda a la mayoría de las categorías en la vecindad N(i, j, s). Mediante los operadores genéticos antes mencionados se generan de forma iterativa nuevos descendientes. El individuo con la mayor aptitud sale cuando no se cumple la condición de iteración, como se muestra en los pasos 10 a 16 del Algoritmo 1. Tenga en cuenta una regla de clasificación inusual de este método propuesto en términos de clasificación LULC. El GA basado en el espacio espectral propuesto realiza solo una clasificación binaria en cada imagen de longitud de onda. Por lo tanto, cuando se han discriminado todos los N tipos de uso de la tierra y N imágenes binarias, los resultados de la clasificación se fusionan en un mapa de clasificación completo. En términos simples, el píxel (i, j) pertenece a la categoría que lo marca como 1 en el mapa de clasificación binaria. Cuando dos o más mapas binarios marcan el píxel como 1, el píxel se clasifica como el que tiene el valor de aptitud mayor, como se muestra en la Fig. 2 y el paso 19 del Algoritmo 1.
Algoritmo 1: El procedimiento del modelo de conjunto de dos pasos propuesto.
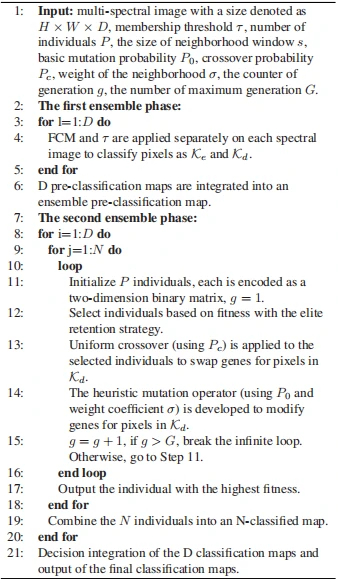
Fig. 2. Combinación de cuatro mapas de resultados de clasificación binaria.
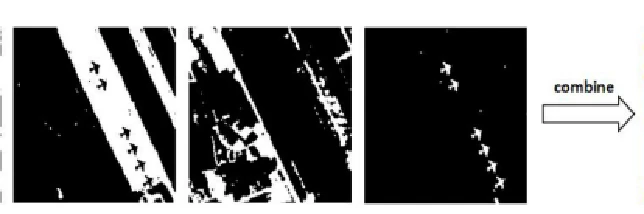
Finalmente, el segundo modelo de conjunto se aplica a los mapas de clasificación D, con el objetivo de fusionar mapas de clasificación de todas las longitudes de onda en el mapa LULC final. Las reglas del conjunto son las siguientes: supongamos que hay nk mapas de clasificación que clasifican el píxel (i, j) como la k-ésima clase, y la categoría final CI(i, j)=k, si nk > nx, donde x ∈ {1, 2,..., N}, x=k, N i=1 ni=D. Tenga en cuenta que en el marco de integración, siempre eliminamos selectivamente la clasificación resultados en la banda NIR porque sus resultados de clasificación suelen ser increíbles.
III. RESULTADOS EXPERIMENTALES
A. Introducción a los datos
Se utilizan tres conjuntos de datos de imágenes de teledetección adquiridas por el satélite Beijing 2 para verificar la precisión y eficacia del algoritmo propuesto. Beijing-2 es una constelación civil comercial de satélites de teledetección (DMC3) que consta de tres satélites de alta resolución. Se lanzó el 11 de julio de 2015 desde la India y se entregó a una distancia de 651 km sincrónica con el sol. El sistema de constelaciones de Beijing-2 proporciona imágenes multiespectrales en órbita de aproximadamente 24 km de ancho, 0,8 m de resolución pancromática y 3,2 m de resolución en azul, verde, rojo e infrarrojo cercano, que pueden proporcionar datos satelitales de teledetección y productos de información espacial. con cobertura global y excelente resolución espacial y temporal, capaz de revisitar cualquier lugar del globo durante uno o dos días. Las imágenes experimentales se obtuvieron en 2018. El sitio de prueba se encuentra en tres partes diferentes de la ciudad de Dangyang, provincia de Hubei, China. En este artículo sólo se consideran imágenes multiespectrales. Realizamos una corrección atmosférica en estos datos de imágenes a través de ENVI (5.3). El modelo atmosférico es el invierno subártico y el modelo de aerosoles es el rural. Además, la recuperación de aerosoles que seleccionamos es 2-banda (KT). Los demás parámetros se configuraron de forma predeterminada. Todas las imágenes son preprocesadas mediante corregistro. Además, se nos ha proporcionado una clasificación ya etiquetada de todas las imágenes en las cuatro o cinco clases. Esto se basa en una inspección visual exhaustiva mediante la observación de la imagen original y registrada en un mapa georreferenciado como verdad sobre el terreno.

cistanche tubulosa-mejora el sistema inmunológico
B. Configuración de parámetros
En este experimento, el umbral τ de FCM es 0.8, el tamaño de la población se establece en 40, la probabilidad de cruce Pc=0.8, la probabilidad de mutación base P0=0.001 , el exponente σ es 2, el tamaño de la ventana de vecindad s se establece en 3 píxeles, con el objetivo de mantener los detalles de la imagen y al mismo tiempo optimizar el tiempo de procesamiento de la computadora y la dirección de convergencia. Se necesitan nueve enfoques de clasificación de cobertura terrestre existentes para verificar la efectividad del método propuesto, incluidos FCM, ENFCM [22], FGFCM [23], FLICM [25], ADFLICM [26], FRFCM [27], FCM{{14} }SICM [28], MRE-DE [33] y P-Kmedias [20]. La configuración de los parámetros es idéntica a la literatura original y no se reitera aquí. Además, el GA simple tiene el mismo parámetro de tamaño de población H y probabilidad de cruce Pc que el algoritmo propuesto en este artículo, la probabilidad de mutación Pm=0.01, pero sin información de vecindad, el lector puede entender que el tamaño de la ventana de vecindad es 1. En particular, nGA retiene el operador genético utilizando información de vecindad pero elimina la operación de conjunto existente en TE-nGA.
C. Resultados de la clasificación
Higos. 3 a 5 muestran los resultados de la clasificación LULC en mapas de colores correspondientes a los diferentes modelos cuando se prueban en cada conjunto de datos. Dado que las tres imágenes captadas remotamente contienen diferentes tipos de uso de la tierra, la representación de colores del cuadro de clasificación no es uniforme. Según estos resultados de clasificación, para tres figuras, los mapas de color obtenidos mediante el método propuesto son más claros y fluidos. La Tabla I muestra los tiempos (tiempo de ejecución) y OA logrados por los 12 modelos y cuando se probaron en áreas de investigación para comparar el rendimiento de clasificación con diferentes métodos. Los mejores resultados experimentales se muestran en negrita. Se puede concluir que el método propuesto presentó los mejores resultados generales, con el OA más alto del 88,72% y relativamente pocos píxeles incorrectos. Para el Área 3, cuando se utilizan las ventanas de vecindario, la precisión de clasificación de LULC aumenta en un 28,35 %; Más importante aún, TE-nGA puede reducir el tiempo de cálculo a 9257,56 s, en comparación con el GA simple. Esto se debe a que el operador de mutación heurística de TE-nGA puede controlar de forma adaptativa la dirección de búsqueda para acelerar la convergencia del algoritmo, lo que demuestra que el método propuesto es más adecuado para escenarios prácticos. Además, nGA es equivalente a la operación de eliminación de conjunto de TE-nGA, por lo que el lector puede comprender que TE-nGA se ejecuta solo en la imagen de banda única (banda1). Para el Área 3, cuando se introducen marcos de conjunto, la precisión de la clasificación mejora aún más en un 0.72 %, lo que demuestra la eficacia de la estrategia de conjunto.
D. Análisis de parámetros
Uno de los elementos esenciales del método propuesto es considerar la información de vecindad espacial como información heurística para modificar de forma adaptativa la función objetivo y la probabilidad de mutación, mejorando así la inmunidad al ruido y la precisión de la clasificación, así como la velocidad de convergencia. Sin embargo, esto no significa que cuanto mayor sea el tamaño de la ventana, mejor será el efecto de clasificación. Con respecto a la Tabla II, se observa un mayor rendimiento al considerar la información de vecindad espacial, al aumentar el tamaño de la ventana hasta un umbral apropiado y luego disminuir. Todo es por que las muestras más alejadas del píxel central contribuyen poco a la división de categorías del píxel central e incluso agravan la clasificación errónea. Debido a que los objetos en diversas ubicaciones geográficas presentan diferencias en brillo y textura, el tamaño de ventana óptimo parece ser 5 × 5 para el Área 1 y el Área 2, pero 3 × 3 para el Área 3. Este resultado se puede observar en negrita en la Tabla II. representando la mejor precisión y el tiempo de convergencia más rápido. Además, hemos descubierto que la probabilidad de mutación base P0 y el exponente σ también son factores vitales que afectan el rendimiento de la clasificación. En nuestro estudio, se utilizan diferentes P0 y σ para verificar la interpretación y clasificación de LULC. La Fig. 6 dibuja las curvas de variación de OA a medida que P{{10}} y σ aumentan. Resultó que, para un σ fijo, a medida que aumenta P0, la precisión general de la clasificación primero aumenta y luego disminuye. Se espera este resultado ya que un P0 pequeño hará que la búsqueda se limite a la dirección evolutiva original y, por lo tanto, caiga en un óptimo local; por el contrario, una P0 grande romperá el buen patrón evolutivo y desviará los resultados de la solución óptima. Por otro lado, a medida que σ aumenta, el efecto de la información de vecindad es más significativo y el mejor valor de probabilidad básica cambia gradualmente de mayor a menor. Las ponderaciones de vecindario adecuadas son más propicias para obtener los mejores resultados de clasificación. En nuestra área de investigación, el mejor exponente es σ ∈ {2, 3}, y el rango más apropiado de P0 es [10−5, 10−2].
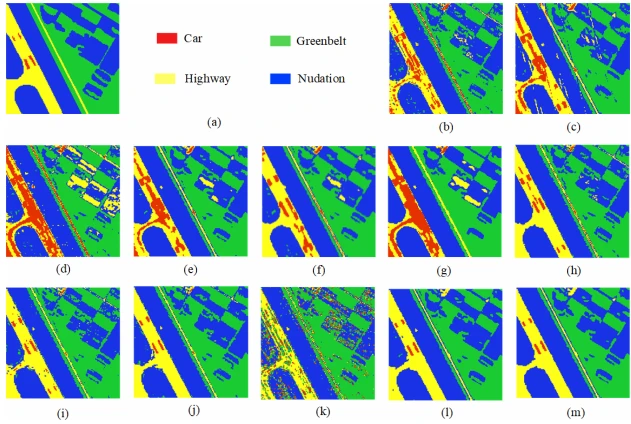
Fig. 3. Resultados de clasificación del área 1. (a) Verdad fundamental. (b) FCM. (c) ENFCM. d) GFCM. (e) FLICM. f) ADFLICM. g) FRFCM. (h) FCM_SICM. (i) MRE-DE. (j) P-K significa. k) AG. (l) nGA. (m) TE-nGA.
TABLA I RESULTADOS DE LA EVALUACIÓN DE OCHO MÉTODOS DIFERENTES DE CLASIFICACIÓN EN TRES ÁREAS DE ESTUDIO


Fig. 4. Resultados de clasificación del área 2. (a) Verdad fundamental. (b) FCM. (c) ENFCM. d) GFCM. (e) FLICM. f) ADFLICM. g) FRFCM. (h) FCM_SICM. (i) MRE-DE. (j) P-K significa. k) AG. (l) nGA. (m) TE-nGA.

Fig. 5. Resultados de clasificación del área 3. (a) Verdad fundamental. (b) FCM. (c) ENFCM. d) GFCM. (e) FLICM. f) ADFLICM. g) FRFCM. (h) FCM_SICM. (i) MRE-DE. (j) P-K significa. k) AG. (i) nGA. (m) TE-nGA.
TABLA II RESULTADOS DE LA EVALUACIÓN DEL TE-NGA PROPUESTO UTILIZANDO VENTANAS DE DIFERENTES TAMAÑOS EN TRES ÁREAS DE ESTUDIO


Fig. 6. Análisis de la probabilidad de mutación base P0 y exponente σ en la probabilidad de mutación heurística.
IV. CONCLUSIÓN
La principal contribución de este estudio es proponer una estrategia de conjunto superior de dos pasos y GA basada en espectro-espacial para la clasificación LULC de imágenes multiespectrales. El primer modelo de conjunto realiza FCM en imágenes multibanda, reduciendo la tarea de clasificación de imágenes detectadas remotamente a la determinación de categorías de píxeles difíciles de agrupar. El segundo procesamiento conjunto comprende dos tareas. En primer lugar, se creó el GA mejorado que combina información espectral y espacial para ofrecer soluciones innovadoras a los acertijos, como una convergencia lenta y un antiruido deficiente. Exactamente, esta mejora se beneficia de las novedosas funciones de aptitud y probabilidad de mutación, utilizando una ventana de vecindad adecuada. Luego, se adopta el modelo de conjunto para integrar los resultados de clasificación derivados de imágenes de múltiples bandas, que se utiliza para reducir el riesgo de clasificación errónea. Los resultados demuestran que el TE-nGA propuesto tiene un rendimiento de clasificación preferible y una convergencia más rápida que el GA simple. En el futuro, esperamos ampliar la aplicación de la técnica propuesta a otros campos, como la clasificación de cultivos, la detección de objetivos y la clasificación de imágenes hiperespectrales.

Beneficios de la cistanche tubulosa-fortalecer el sistema inmunológico
REFERENCIAS
[1] T. Hermosilla, MA Wulder, JC White y NC Coops, "Clasificación de la cobertura terrestre en una era de datos grandes y abiertos: optimización de la implementación localizada y la selección de datos de capacitación para mejorar los resultados del mapeo", Remote Sens. Environ., vol. . 268, 2022, art. No. 112780.
[2] P. Helber, B. Bischke, A. Dengel y D. Borth, "EuroSAT: un conjunto de datos novedoso y un punto de referencia de aprendizaje profundo para la clasificación del uso y la cobertura del suelo", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 12, núm. 7, págs. 2217–2226, julio de 2019.
[3] C. Li, G. Xian, Q. Zhou y BW Pengra, "Un nuevo método de aprendizaje automático de fenología (APL) para entrenar la selección de muestras utilizando múltiples conjuntos de datos para el mapeo de cobertura terrestre de series temporales", Remote Sens. Environ. , vol. 266 de 2021, art. No. 112670.
[4] S. Ji, D. Wang y M. Luo, "Adaptación del dominio espacial completo basada en redes adversas generativas para la clasificación de la cobertura terrestre a partir de imágenes de detección remota de múltiples fuentes", IEEE Trans. Geociencias. Sensores remotos, vol. 59, núm. 5, págs. 3816–3828, mayo de 2021.
[5] Y. Quan, Y. Tong, W. Feng, G. Dauphin, W. Huang y M. Xing, "Un nuevo método de fusión de imágenes de imágenes multiespectrales y SAR para la clasificación de la cobertura terrestre", Remote Sens. , vol. 12, núm. 22 de 2020, art. No. 3801.
[6] B. Iqbal y M. Ali, "Estimación de la temperatura del aire espacio-temporal a partir de satélites en un entorno semiárido a árido en la cuenca de Peshawar, noroeste de Pakistán", Adv. Res. espacial, vol. 70, núm. 4, págs. 961–975, 2022.
[7] H.-c. Shih, DA Stow, JR Weeks y LL Coulter, "Determinación del tipo y momento de inicio del cambio de cobertura y uso del suelo en el sur de Ghana basado en un análisis discreto de series temporales densas de imágenes Landsat", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 9, núm. 5, págs. 2064-2073, mayo de 2016.
[8] A. Jamil y B. Bayram, "Extracción de especies de árboles y clasificación de cobertura/uso de la tierra a partir de mapas ortofotográficos digitales de alta resolución", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 11, núm. 1, págs. 89–94, enero de 2018.
[9] Z. Xue, P. Du y L. Feng, "Clasificación de la cobertura terrestre basada en la fenología y análisis de tendencias basado en series de imágenes de teledetección a largo plazo", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 7, núm. 4, págs. 1142-1156, abril de 2014.
[10] Q. Zhu et al., "Detección de cambios en el uso de la tierra y la cobertura del suelo basada en un marco de aprendizaje global siamés para imágenes de teledetección de alta resolución espacial", ISPRS J. Photogrammetry Remote Sens., vol. 184, págs. 63 a 78, 2022.
[11] W. Feng, G. Dauphin, W. Huang, Y. Quan y W. Liao, "Nueva técnica iterativa de submuestreo basada en márgenes en bosques aleatorios modificados para clasificación", Knowl.-Based Syst., vol. 182, 2019, art. No. 104845.
[12] W. Feng et al., "Bosque de rotación basado en técnica de sobremuestreo de minoría sintética dinámica para la clasificación de datos hiperespectrales desequilibrados", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 12, núm. 7, págs. 2159–2169, julio de 2019.
[13] Y. Sun, L. Mou, Y. Wang, S. Montazeri y XX Zhu, "Recuperación de altura de edificios a gran escala a partir de imágenes SAR únicas basadas en redes de regresión de cuadros delimitadores", ISPRS J. Photogrammetry Remote Sens., vol. 184, págs. 79–95, 2022.
[14] R. Yang, X. Xu, Z. Xu, H. Dong, R. Gui y F. Pu, "Análisis dinámico de textura fractal para la clasificación de la cobertura terrestre de PolSAR", IEEE Trans. Geociencias. Sensores remotos, vol. 57, núm. 8, págs. 5991–6002, agosto de 2019
[15] S. Saha, F. Bovolo y L. Bruzzone, "Construcción de detección de cambios en imágenes VHR SAR mediante transcodificación profunda no supervisada", IEEE Trans. Geociencias. Sensores remotos, vol. 59, núm. 3, págs. 1917-1929, marzo de 2021.
[16] MK Islam, MS Ali, MS Miah, MM Rahman, MS Alam y MA Hossain, "Detección de tumores cerebrales en imágenes de resonancia magnética utilizando superpíxeles, análisis de componentes principales y algoritmo de agrupamiento de medias k basado en plantillas", Mach. Aprender. Aplicación, vol. 5, 2021, art. No. 100044.
[17] Q. Wang, Q. Li, H. Liu, Y. Wang y J. Zhu, "Un algoritmo ISODATA mejorado para la clasificación de imágenes hiperespectrales", en Proc. 7° Int. Congr. Proceso de señal de imagen., 2014, págs. 660–664.
[18] S. Ghaffarian y S. Ghaffarian, "Agrupación automática de cmeans difusos basada en histogramas para imágenes de teledetección", ISPRS J. Photogrammetry Remote Sens., vol. 97, págs. 46–57, 2014.
[19] TH Dang, DS Mai y LT Ngo, "Algoritmo colaborativo de agrupamiento difuso de múltiples núcleos con superpíxeles ponderados para la clasificación de cobertura terrestre de imágenes satelitales", Eng. Aplica. Artif. Intel., vol. 85, págs. 85–98, 2019.
[20] E. Paradis, "Clasificación probabilística no supervisada para análisis a gran escala de datos de imágenes espectrales", Int. J. Aplica. Geoinformación de observación de la Tierra, vol. 107, 2022, art. No. 102675.
[21] X. Hu, X. Wang, Y. Zhong y L. Zhang, "S3aNet: red de atención a escala espectral-espacial para una clasificación de cultivos precisa de un extremo a otro basada en imágenes H2 transmitidas por vehículos aéreos no tripulados", ISPRS J. Photogrammetry Sensores remotos, vol. 183, págs. 147-163, 2022.
[22] L. Szilagyi, Z. Benyo, S. Szilagyi y H. Adam, "Segmentación de imágenes cerebrales utilizando un algoritmo difuso mejorado de c-means", en Proc. 25º año. En t. Conf. Ing. IEEE. Medicina. Biol. Soc., 2003, vol. 1, págs. 724–726.
[23] W. Cai, S. Chen y D. Zhang, "Algoritmos de agrupación de medios difusos rápidos y robustos que incorporan información local para la segmentación de imágenes", Pattern Recognit., vol. 40, núm. 3, págs. 825–838, 2007.
[24] Y. Zhang, X. Bai, R. Fan y Z. Wang, "C-medias difusas con desviación escasa y restricción de información del vecino", IEEE Trans. Sistema difuso, vol. 27, núm. 1, págs. 185-199, enero de 2019.
[25] S. Krinidis y V. Chatzis, "Un algoritmo robusto de agrupación de medios C de información local difusa", IEEE Trans. Proceso de imagen., vol. 19, núm. 5, págs. 1328-1337, mayo de 2010.
[26] H. Zhang, Q. Wang, W. Shi y M. Hao, "Un nuevo algoritmo de agrupamiento de medios C de información local difusa adaptativa para la clasificación de imágenes detectadas remotamente", IEEE Trans. Geociencias. Sensores remotos, vol. 55, núm. 9, págs. 5057–5068, septiembre de 2017.
[27] T. Lei, X. Jia, Y. Zhang, L. He, H. Meng y AK Nandi, "Algoritmo de agrupación de medias C difusa significativamente rápido y robusto basado en reconstrucción morfológica y filtrado de membresía", IEEE Trans. Sistema difuso, vol. 26, núm. 5, págs. 3027–3041, octubre de 2018.
[28] Q. Wang, X. Wang, C. Fang y W. Yang, "Algoritmo robusto de agrupamiento de medias C difusas con restricción espacial y de intensidad adaptativa y vinculación de membresía para la segmentación de imágenes de ruido", Appl. Computación blanda, vol. 92, 2020, art. No. 106318.
[29] G. Yiqiang, W. Yanbin, J. Zhengshan, W. Jun y Z. Luyan, "Clasificación de imágenes de teledetección mediante el algoritmo genético del caos en el seguimiento de los cambios en el uso de la tierra", Math. Computadora. Modelo., vol. 51, núm. 11, págs. 1408-1416, 2010.
[30] M. Iqbal, B. Xue, H. Al-Sahaf y M. Zhang, "Reutilización entre dominios del conocimiento extraído en programación genética para la clasificación de imágenes", IEEE Trans. Evolución. Computación, vol. 21, núm. 4, págs. 569–587, agosto de 2017.
[31] R. Hamad, "Un análisis basado en sensores remotos y SIG de la expansión urbana en el distrito de Soran, Kurdistán iraquí", SN Appl. Ciencia, vol. 2, núm. 1, págs. 1 a 9, 2019.
[32] H. Yang, Q. Du y G. Chen, "Reducción de la dimensionalidad hiperespectral basada en la optimización del enjambre de partículas para la clasificación de la cobertura del suelo urbano", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 5, núm. 2, págs. 544–554, abril de 2012.
[33] S. Sarkar, S. Das y SS Chaudhuri, "Segmentación de imágenes hiperespectrales utilizando umbrales multinivel basados en entropía de Rényi ayudados con evolución diferencial", Expert Syst. Aplicación, vol. 50, págs. 120-129, 2016.
[34] S. Sen Gupta, S. Hossain y K.-D. Kim, "Imagen similar a HDR a partir de la fusión de imágenes de pseudoexposición: un enfoque de algoritmo genético", IEEE Trans. Consumir. Electron., vol. 67, núm. 2, págs. 119-128, mayo de 2021.
[35] C. Peng, X. Wu, W. Yuan, X. Zhang, Y. Zhang e Y. Li, "MGRFE: eliminación de características recursivas multicapa basada en un algoritmo genético integrado para la clasificación del cáncer", IEEE/ACM Trans . Computadora. Biol. Bioinf., vol. 18, núm. 2, págs. 621–632, marzo/abril. 2021.
[36] HH Zhang, ZS Xue, XY Liu, P. Li, L. Jiang y GM Shi, "Optimización del canal de alta velocidad para la integridad de la señal con un algoritmo genético profundo", IEEE Trans. Electromagn. Compat., vol. 64, núm. 4, págs. 1270-1274, agosto de 2022.
[37] Z. Huang, W. Wu, H. Liu, W. Zhang y J. Hu, "Identificación de cambios dinámicos en la superficie del agua utilizando datos centinela-1 basados en algoritmos genéticos y técnicas de aprendizaje automático", Remote Sens., vol. 13, núm. 18 de 2021, art. No. 3745.
[38] F. Ye, C. Doerr, H. Wang y T. Bäck, "Configuración automatizada de algoritmos genéticos mediante ajuste para el rendimiento en cualquier momento", IEEE Trans. Evolución. Computación, vol. 26, núm. 6, págs. 1526-1538, diciembre de 2022.
[39] MG Souza, EE Vallejo y K. Estrada, "Detección de asociaciones de variantes raras independientes agrupadas mediante algoritmos genéticos", IEEE/ACM Trans. Computadora. Biol. Bioinf., vol. 18, núm. 3, págs. 932–939, mayo/junio. 2021.
[40] T. Dutta, S. Dey, S. Bhattacharyya, S. Mukhopadhyay y P. Chakrabarti, "Umbral de imágenes hiperespectrales de varios niveles utilizando el algoritmo genético qutrit", Expert Syst. Aplicación, vol. 181, 2021, art. No. 115107.
[41] Y.-R. Chen, J.-W. Chen, S.-C. Hsieh y P.-N. Ni, "La aplicación de la tecnología de teledetección a la interpretación del uso de la tierra en caso de deslizamientos de tierra inducidos por lluvias basados en algoritmos genéticos y redes neuronales artificiales", IEEE J. Sel. Temas Aplica. Observador de la Tierra. Sensores remotos, vol. 2, núm. 2, págs. 87–95, junio de 2009.
[42] D. Corus y PS Oliveto, "Los algoritmos genéticos estándar de estado estacionario pueden escalar más rápido que los algoritmos evolutivos de sólo mutación", IEEE Trans. Evolución. Computación, vol. 22, núm. 5, págs. 720–732, octubre de 2018.
[43] TL Cerqueira, FC Bertoni y MG Pires, "Selección genética de instancias para la optimización de sistemas basados en reglas difusas para la clasificación de opiniones", IEEE Latin Amer. Trans., vol. 18, núm. 7, págs. 1215-1221, julio de 2020.
[44] JE Batista, AIR Cabral, MJP Vasconcelos, L. Vanneschi y S. Silva, "Mejora de la clasificación de la cobertura terrestre utilizando programación genética para la construcción de características", Remote Sens., vol. 13, núm. 9 de 2021, art. No. 1623.
[45] A. Mohammadi, H. Asadi, S. Mohamed, K. Nelson y S. Nahavandi, "Algoritmos genéticos interactivos y multiobjetivos para el ajuste del peso de un algoritmo de señales de movimiento basado en control predictivo modelo", IEEE Trans. Cybern., vol. 49, núm. 9, págs. 3471–3481, septiembre de 2019.
[46] A. Khoder y F. Dornaika, "Aprendizaje conjunto mediante selección de características y múltiples subconjuntos transformados: aplicación a la clasificación de imágenes", Appl. Suave. Computación, vol. 113, 2021, art. No. 108006.
[47] W. Feng, W. Huang y W. Bao, "Clasificación de imágenes hiperespectrales desequilibradas con un método de conjunto adaptativo basado en SMOTE y bosque de rotación con tasas de muestreo diferenciadas", IEEE Geosci. Sensores remotos. Lett., vol. 16, núm. 12, págs. 1879–1883, diciembre de 2019.
[48] W. Feng et al., "Bosque de rotación semisupervisado basado en la teoría del margen de conjunto para la clasificación de imágenes hiperespectrales con datos de entrenamiento limitados", Inf. Ciencia, vol. 575, págs. 611–638, 2021.
[49] Z. Zhu, Z. Wang, D. Li, Y. Zhu y W. Du, "Aprendizaje de conjuntos estructurales geométricos para problemas de desequilibrio", IEEE Trans. Cybern., vol. 50, núm. 4, págs. 1617-1629, abril de 2020.
[50] Q. Sun y Z. Ge, "Aprendizaje profundo para la predicción de KPI industriales: cuando el aprendizaje conjunto se encuentra con datos semisupervisados", IEEE Trans. Ind. Informat., vol. 17, núm. 1, págs. 260–269, enero de 2021.
[51] X. Gu, C. Zhang, Q. Shen, J. Han, PP Angelov y PM Atkinson, "Un marco de conjunto basado en prototipos jerárquicos de autoformación para la clasificación de escenas de teledetección", Inf. Fusión, vol. 80, págs. 179-204, 2022.
[52] B. Wang, L. Xia, D. Song, Z. Li y N. Wang, "Un método de aprendizaje conjunto basado en una estrategia de votación de peso de dos rondas para la clasificación del hielo marino de imágenes centinela-1, "Sentidos remotos, vol. 13, núm. 19 de 2021, art. No. 3945.
[53] K. Dabov, A. Foi, V. Katkovnik y K. Egiazarian, "Eliminación de ruido de imágenes mediante filtrado colaborativo de dominio de transformación 3-D disperso", IEEE Trans. Proceso de imagen., vol. 16, núm. 8, págs. 2080–2095, agosto de 2007.