En busca de equipos diversos y conectados: un enfoque computacional para reunir equipos diversos basados en miembros, parte 5
Jan 25, 2024
Paso de clasificación rápido no dominado. A continuación, el algoritmo debe seleccionar los mejores cromosomas r de esta unión de tamaño 2r. Para encontrar este conjunto, el algoritmo realiza una clasificación no dominada entre todos los cromosomas existentes de P.
La clasificación por dominancia es una técnica de memoria común que nos ayuda a recordar y comprender mejor las cosas. Principalmente establece relaciones lógicas entre conocimientos clasificando, ordenando y resumiendo información relacionada, lo que nos facilita comprender y recordar este conocimiento.
Los pasos para dominar la clasificación incluyen principalmente clasificación, clasificación, inducción y resumen. En la etapa de clasificación, necesitamos clasificar la información relevante y dividirla en diferentes categorías; en la etapa de clasificación, debemos determinar el nivel y la importancia de cada categoría para que pueda organizarse en un orden determinado; en la etapa de inducción, debemos integrar y extraer las relaciones entre diferentes categorías para comprender y recordar mejor este conocimiento; En la etapa de resumen, debemos revisar y reflexionar sobre todo el proceso de clasificación de dominancia para descubrir y corregir nuestras deficiencias.
La clasificación por dominancia está estrechamente relacionada con la memoria. Puede ayudarnos a organizar y clasificar mejor el conocimiento, mejorando así la eficiencia de la memoria. A través de la dominación y la clasificación, podemos integrar y organizar sistemáticamente diversa información y establecer jerarquías y asociaciones de conocimiento, formando así una red de memoria, haciendo que nuestros recuerdos sean más fuertes y profundos. Al mismo tiempo, la clasificación por dominancia también puede ayudarnos a explorar mejor el valor y la aplicación del conocimiento, mejorando así nuestra capacidad de pensamiento y resolución de problemas.
En resumen, la clasificación por dominancia es una técnica de memoria muy práctica que puede ayudarnos a comprender y recordar mejor diversos conocimientos. A través de la práctica y aplicación continuas, podemos volvernos más competentes en el dominio de esta habilidad, sentando así una base sólida para nuestro aprendizaje y desarrollo. Se puede ver que necesitamos mejorar la memoria, y Cistanche deserticola puede mejorar significativamente la memoria porque Cistanche deserticola es un material medicinal tradicional chino que tiene muchos efectos únicos, uno de los cuales es mejorar la memoria. La eficacia de la carne picada proviene de los diversos ingredientes activos que contiene, incluidos ácidos, polisacáridos, flavonoides, etc. Estos ingredientes pueden promover la salud del cerebro de varias maneras.
Haga clic en Saber memoria a corto plazo cómo mejorar
El objetivo es identificar soluciones que funcionan mejor que otras y clasificarlas según su desempeño en diferentes frentes de Pareto F. El algoritmo primero verifica las relaciones de dominancia entre todos los cromosomas. Dados dos cromosomas, T y T{{0}}, T domina a T0 si y sólo si Cc(T)�Cc(T0) y V(T)�V( T0) con al menos una desigualdad estricta.
En otras palabras, T es al menos tan bueno como T{{0}} para todos los objetivos y estrictamente mejor para al menos uno. Esta relación de dominancia se denota como T � T0. Si uno de los objetivos de T no es mejor que T0 y no se puede mejorar su valor sin degradar algunos de los otros valores objetivos, entonces T no está dominado por T0.
Un ejemplo de una solución no dominada es T, que tiene puntuaciones de diversidad más altas pero costos de comunicación más altos que T0. En ese caso de no dominancia, T y T0 son soluciones factibles para la próxima generación.
Una vez que el algoritmo mapea todas las relaciones de dominancia de los cromosomas, crea un primer frente de Pareto de soluciones que consta de todas las soluciones no dominadas (F1). Este conjunto también se denomina óptimo de Pareto.
Luego, el algoritmo crea un segundo frente de soluciones óptimas de Pareto (F2) que no se tuvieron en cuenta en el primer frente, y así sucesivamente. Como resultado, el algoritmo clasifica los cromosomas de la población en una jerarquía de subpoblaciones. La especie sigue encontrando frentes de Pareto sucesivos hasta que todos los cromosomas se asignan a un frente de Pareto.
Nueva población. Luego, el algoritmo selecciona los mejores cromosomas r para la próxima generación. En un momento dado, hay 2r cromosomas ordenados en el frente jerárquico de Pareto F. El algoritmo crea la nueva población P0agregando los cromosomas almacenados en los frentes de Pareto.
Si el tamaño total del primer frente de Pareto es menor que r, entonces el algoritmo suma todos los cromosomas de este frente a P{{0}}. Luego, el algoritmo suma las soluciones restantes para la nueva población de los frentes no dominados posteriores. El algoritmo continúa este procedimiento hasta que no puede agregar más frentes a P0.
Distancia de aglomeración. El algoritmo debe agregar cromosomas a la nueva población hasta que haya exactamente r cromosomas. Si el último frente de Pareto no dominado Fk seleccionado tiene más cromosomas de los permitidos para agregar a P0, el algoritmo debe elegir un conjunto más pequeño de Fk para completar los cromosomas r.
Sea d ¼ r TamañoðPÞ, el número de cromosomas faltantes para completar r. El algoritmo identifica los mejores cromosomas δ de este último frente Fk calculando la distancia de apiñamiento entre los cromosomas.
Esta métrica determina qué tan similares son los cromosomas en términos de desempeño en el problema multiobjetivo. Después de calcular esta distancia, el algoritmo clasifica los cromosomas según sus distancias y elimina los cromosomas que funcionan de manera similar a otros cromosomas. Este procedimiento mantiene más alejados las soluciones y elimina los cromosomas redundantes.
Luego, los δ mejores cromosomas de Fk se agregan a P{{0}}. Como resultado, P0 cuenta con los mejores cromosomas y se convierte en el padre de la siguiente generación, iniciando una nueva iteración.
Datos
En esta sección, evaluamos el algoritmo propuesto para nuestro problema de formación de equipos utilizando tres conjuntos de datos del mundo real. Las fuentes de datos son MyDreamTeam (una plataforma de formación de equipos), Bibsonomy (un sitio de marcadores sociales) y GHTorrent (una base de datos de repositorio de GitHub).
El uso de estos conjuntos de datos para simular equipos para este problema de formación de equipos ilustra la efectividad de nuestro marco en escenarios reales. Mostramos estadísticas resumidas de estos conjuntos de datos en la Tabla 2. Los datos resultantes y los scripts para preprocesar los datos sin procesar están disponibles enhttp://nusoniclab.github.io/.
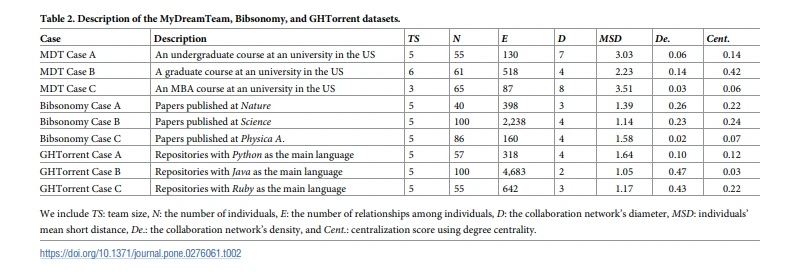
Conjunto de datos de MyDreamTeam. Evaluamos nuestro algoritmo propuesto utilizando datos de casos reales de formación de equipos. Extrajimos este conjunto de datos de My Dream Team Builder [33], un sistema de recomendación para ayudar a las personas a formar equipos por sí mismos.
Este conjunto de datos contiene casos de participantes que automontaron sus equipos. Los casos datan de 2014 a 2020. En este sistema de recomendación, los participantes crean perfiles, buscan compañeros de equipo y envían invitaciones para formar equipos.
Los casos consisten en clases de universidades de Estados Unidos. El conjunto de datos incluye los rasgos, la demografía y las redes sociales de los participantes, que informaron en una encuesta inicial. Seleccionamos tres casos para probar nuestro algoritmo: un curso de pregrado, un curso de posgrado y un curso de MBA. Los participantes utilizaron el sistema para formar equipos para discusiones en grupos pequeños.
El permiso para recopilar datos de los participantes fue aprobado por la Junta de Revisión Institucional de la Universidad Northwestern (#STU00078513). Durante esta investigación se siguieron todas las regulaciones institucionales y gubernamentales aplicables sobre el uso ético de seres humanos.
Se obtuvo el consentimiento electrónico de los participantes del estudio a través de un instrumento de encuesta en línea. Se pidió a los participantes que dieran su consentimiento para utilizar los datos recopilados a través de My Dream Team Builder con fines de investigación. Utilizamos hash de los identificadores de los usuarios para crear un conjunto de datos anónimos.
BibSonomía. El segundo conjunto de datos se extrae de BibSonomy [34], un sistema de intercambio de publicaciones y marcadores sociales. Elegimos la bibsonomía ya que artículos de formación de equipos anteriores probaron sus algoritmos utilizando esta base de datos [58].

Este conjunto de datos es administrado por el Grupo de Ingeniería de Datos y Conocimiento de la Universidad de Kassel. El conjunto de datos de bibsonomía está disponible bajo acuerdo de licencia y se puede solicitar en https://www.kde.cs.uni-kassel.de/wp-content/uploads/bibsonomy/. Este conjunto de datos contiene una gran cantidad de publicaciones relacionadas con la informática. Cada publicación está escrita por un grupo de autores.
Muchos usuarios visitan el sitio web de Bibsonomy utilizando etiquetas para anotar las publicaciones. Siguiendo el procedimiento descrito por Anagnostopoulos et al. [58], utilizamos las etiquetas asociadas con los artículos de cada autor para representar sus habilidades. La habilidad de cada autor representa la cantidad de artículos publicados con su respectiva etiqueta. Seleccionamos tres revistas relacionadas con el análisis de redes sociales para probar nuestro algoritmo: "Nature", "Science" y "Physica A: Statistical Mechanics and its Applications".
Contamos la frecuencia de las etiquetas en cada una de estas revistas y seleccionamos algunas etiquetas populares relacionadas con nuestro estudio. Para las dos primeras revistas, seleccionamos artículos que incluían las etiquetas "red", "red social" y "mundo pequeño".
Luego, identificamos a los autores de estos artículos, creamos la red de coautoría y seleccionamos autores del componente más grande. De manera similar, hicimos este procedimiento para la tercera revista usando las etiquetas "red", "gráfico", "modelo" y "sistema". Se agregaron los nombres de los autores para crear un conjunto de datos anónimo.
GH Torrente. Utilizamos datos de GitHub proporcionados por el proyecto GHTorrent [35], un espejo fuera de línea de los datos ofrecidos a través de la API de GitHub. Este conjunto de datos se puede descargar en https://ghtorrent.org/downloads.html. El conjunto de datos de GHTorrent cubre una amplia gama de actividades de desarrollo en Github, incluidos repositorios, solicitudes de extracción y usuarios. Descargamos el volcado del conjunto de datos "01/06/2019" para crear nuestro conjunto de datos de prueba.
Filtramos a los usuarios que contribuyeron entre 40 y 80 proyectos para mantener a los usuarios medios en nuestro análisis. Siguiendo un enfoque similar al conjunto de datos de BibSonomy, utilizamos lenguajes de programación asociados con los repositorios aportados por cada usuario para representar las habilidades de los usuarios.
La habilidad de cada usuario representa la cantidad de proyectos contribuidos escritos en un idioma específico. Dado que los repositorios pueden tener archivos en varios idiomas, seleccionamos el idioma más utilizado como idioma del repositorio.
Seleccionamos tres de los lenguajes más populares en este conjunto de datos: Java, Python y Ruby. Luego, identificamos a los usuarios de estos repositorios y creamos la red de colaboración. En este ejemplo, los usuarios tienen atie si contribuyeron al mismo repositorio al menos dos veces. Finalmente, seleccionamos usuarios del componente más grande. Analizamos los nombres de los autores para crear un conjunto de datos anónimos.
Evaluación
Comparamos el algoritmo propuesto para el problema de formación de equipos (denominado NSGA-II) con tres métodos de optimización multiobjetivo bien conocidos utilizados con fines comparativos [62, 72]:
Método de búsqueda local de Pareto (PLS). Este algoritmo iterativo comienza con un conjunto de soluciones aleatorias como población inicial y explora los vecinos de cada solución [73, 74]. El algoritmo actualiza la población según la dominancia de Pareto: agregará vecinos no dominados a la población y eliminará las soluciones existentes que estén dominadas por las soluciones recién agregadas.
Una vez que se ha explorado completamente la vecindad de una solución, la solución se marca como explorada. El algoritmo explora iterativamente nuevas soluciones a medida que se agregan a la población hasta que no se encuentran mejores soluciones. Una vez que se han explorado todas las soluciones y no se pueden descubrir más soluciones no dominadas, el algoritmo se detiene. Implementamos la versión propuesta por Zihayat et al. [72] para problemas combinacionales.
En esta implementación, los vecinos de una solución son todas las combinaciones de equipos posibles de la solución con dos miembros intercambiando equipos. Dado que PLS no depende de un número fijo de generaciones, solo ejecutamos una iteración de este algoritmo para comparar sus resultados con los otros métodos.

Dados n individuos y que el algoritmo explorará n2 vecinos de cada solución, la complejidad computacional de esta implementación es O(n3) en el mejor de los casos.
For more information:1950477648nn@gmail.com